RAG の索引を Amazon S3 Vectors に置くか OpenSearch に置くか。paperlake(前回で Golden セットという物差しを作った)は月 1 ドル未満の S3 Vectors を選んでいるが、「1,000 人規模になったら OpenSearch だろうな」という話をしているうちに、実際に測りたくなった。Bedrock Knowledge Base は索引の置き場所を両方選べるので、同じ資料・同じチャンク分割・同じ埋め込みで、索引だけを差し替えて同じ 40 問を投げれば白黒がつく。結論を先に書くと、索引の置き場所では精度も速度も差が出ず、OpenSearch でしか使えないハイブリッド検索だけが効いた。そして OpenSearch は 45 分で壊した。
その前に、検索画面を作った
測る前にひとつ道具を足した。「検索」タブである。
これまで検索の品質を見る手段は、Golden セットの自動評価(40 問の hit@k)か、Claude に MCP 経由で聞いて答えを眺めるかの二つだった。前者は数字しか出ず、後者は Claude が答えを組み立てた後の姿しか見えない。「なぜこの質問で期待のページが 4 位なのか」を掘るには、Claude が答える前に検索基盤そのものが何を返したかを人が見る画面が要る。
作ったのは Knowledge Base の Retrieve 結果を加工せずに並べるだけの画面だ。順位、類似度スコア、資料名、入力順のページと印刷ページ番号、生のチャンク、所要時間。ブラウザから AWS には直接つながず、サーバーの FastAPI が boto3 で Retrieve を呼ぶので、ブラウザに認証情報を持たせなくてよい。API は POST /api/search ひとつで、戻り値は MCP の検索ツールと同じ形にした。
スコアの見せ方だけ気を遣った。0.81 は「81% 正しい」ではない。類似度であって正解確率ではないので、画面にも使い方にもそう書いた。
作ってすぐ、多義語の例が見えた。「プロファイリングによって何が分かる?」と聞くと、1 位は技術資料のプロファイラの話ではなく、犯罪心理学の資料のプロファイリングだった。意味検索は「プロファイリング」の意味を片方に寄せて解釈する。これは検索の失敗ではなく、質問が曖昧なだけなのだが、自動評価の数字だけ見ていたら「なぜ外れたのか」は分からなかった。
実験の組み方
Terraform に変数をひとつ足した。opensearch_kb = true のときだけ、OpenSearch Serverless のコレクションと、それを索引にした 2 つ目の Knowledge Base を作る。データソースは本番と同じ S3 バケット、チャンク分割も同じ階層チャンク(1,500 / 300 トークン)、埋め込みも同じ Titan Text Embeddings v2。違うのは索引の置き場所だけ、という条件を Terraform で保証する。
OpenSearch Serverless は使っていなくても最低 OCU 分が時間課金される。待機レプリカを切った開発用でも 2 OCU で 1 時間 0.5 ドル弱、置きっぱなしにすると月 350 ドルになる。だから既定は false で、測り終えたら false に戻して destroy する前提の変数にした。
403 が 12 回
ひとつ躓いた。Terraform の AWS プロバイダには OpenSearch Serverless の「索引」を作る資源がない(コレクションとポリシーはある)。Knowledge Base は既存の索引を参照するので、索引だけは自分で作る必要がある。そこで SigV4 署名をした HTTP リクエストで索引を作る小さな Python スクリプトを書き、Terraform の local-exec から呼ぶことにした。
ところがコレクションが ACTIVE になっても、索引作成が 403 Forbidden を返し続ける。データアクセスポリシーには自分の IAM ユーザーを入れてあるし、IAM 側は管理者権限だ。ポリシーの反映待ちかと思って 10 秒おきに 12 回試しても 403 のまま。
原因は署名の中身だった。OpenSearch Serverless は S3 と同じく x-amz-content-sha256 ヘッダ(リクエスト本文のハッシュ)を要求する。botocore の汎用の SigV4 署名はこのヘッダを付けないので、署名自体は正しいのに 403 になる。ヘッダを 1 行足したら一発で通った。エラーが「Forbidden」なので権限を疑ってしまうが、権限ではなく署名の形式の問題だった。
3 条件
比較したのは次の 3 つ。
- S3 Vectors、意味検索(本番)
- OpenSearch Serverless、意味検索
- OpenSearch Serverless、ハイブリッド検索(意味の近さに BM25 のキーワード一致を足す。Retrieve の
overrideSearchType = HYBRID)
3 は S3 Vectors では選べない。だから「索引の置き場所の差」は 1 と 2 の比較で、「OpenSearch にしたら使える機能の差」は 2 と 3 の比較で見る。
評価スクリプトには検索方式の指定と、Retrieve 1 回ごとの所要時間の記録を足した。速度も気になっていたからだ。
結果
指標を先に説明しておく。Golden セットは「質問」と「その答えが書いてある資料とページ」の組が 40 問ある。1 問ずつ検索して上位 5 件を取り、正解のページが何位に出たかを見る。
- hit@k: 上位 k 件の中に正解が入っていた質問の割合。hit@1 は「一発で正解を最上位に出せた率」、hit@5 は「5 件渡せばその中に正解がある率」。RAG では検索結果を数件まとめて LLM に渡すので、hit@5 が「答えを作れる材料が届く率」、hit@1 が「検索が迷いなく当てる率」にあたる
- MRR: 正解が出た順位の逆数の平均。1 位なら 1、2 位なら 0.5、圏外なら 0。hit@k が「入ったかどうか」しか見ないのに対し、2 位が 1 位に上がるような改善も拾う
たとえば hit@1 が 0.400 から 0.550 に上がった、というのは「40 問中 16 問が 1 位だったのが 22 問になった」という意味である。
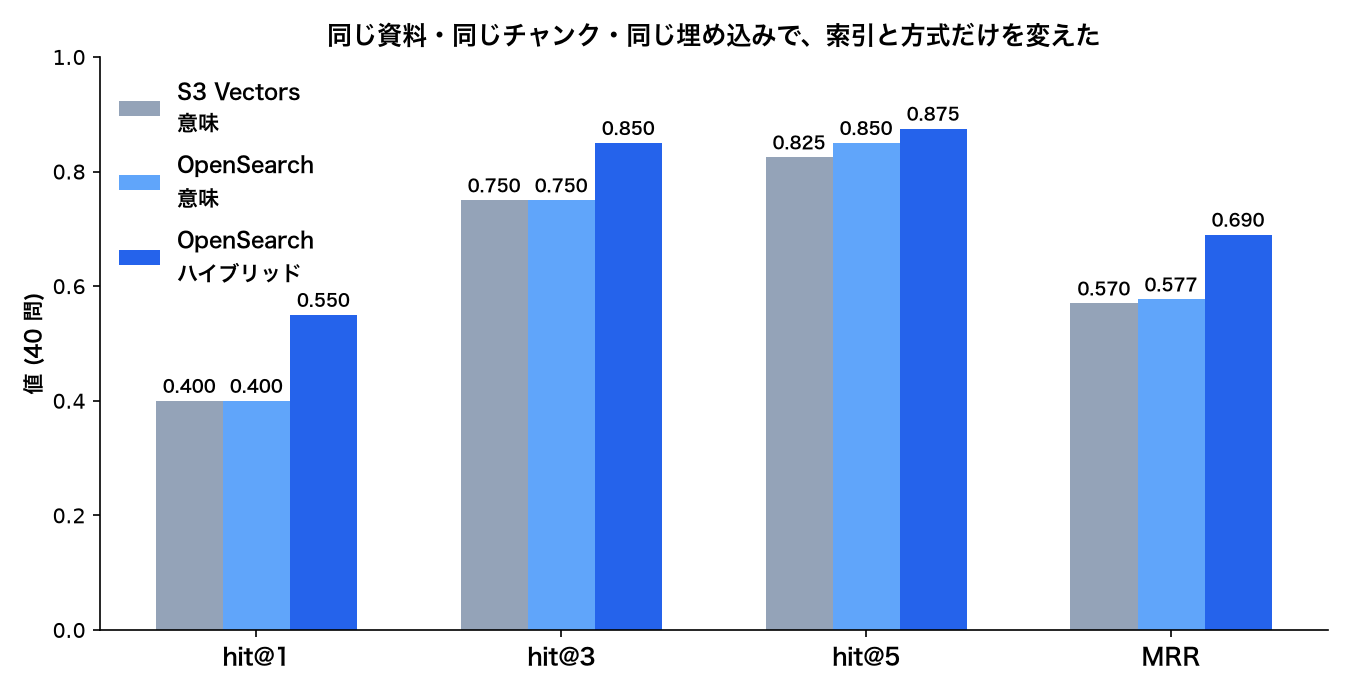
| 索引 | 方式 | hit@1 | hit@3 | hit@5 | MRR | 所要時間の中央値 |
|---|---|---|---|---|---|---|
| S3 Vectors | 意味 | 0.400 | 0.750 | 0.825 | 0.570 | 299 ms |
| OpenSearch | 意味 | 0.400 | 0.750 | 0.850 | 0.577 | 297 ms |
| OpenSearch | ハイブリッド | 0.550 | 0.850 | 0.875 | 0.690 | 321 ms |
所要時間はサーバー(GPU サーバーのコンテナ内)から Retrieve を呼んだときの往復で、10 問の中央値。
索引の置き場所では差が出ない
1 と 2 は、40 問のうち順位が変わったのが 1 問だけ(5 位圏外 → 4 位)。同じベクトルを同じ距離で引いているのだから当然といえば当然で、近似最近傍の実装が違っても上位 5 件はほぼ一致する。
速度も同じだった。「OpenSearch は速い」という先入観があったが、Retrieve の往復 300 ms のうち索引の検索時間はごく一部で、質問文の埋め込みと Bedrock の API の時間が支配している。索引側が数十 ms 速くなっても誤差に埋もれる。この規模で「速さのために OpenSearch」は成り立たない。
ハイブリッドは効く
2 と 3 では hit@1 が 6 問分上がった。この Golden セットの分解能は前回の測定から ±1 問程度と見ているので、はっきり効いている。
上がった質問には型がある。信号方式の略語、交換局の種別、ビット演算子の名前、コマンド名、小説の中の固有の言い回し。答えのページに質問と同じ語がそのまま書かれている質問だ。意味検索は「同じ意味の別の言い方」を拾うのが得意な代わりに、「この語そのもの」を優先しない。キーワード一致はそこを補う。
下がった質問も 3 問あって、こちらも型がある。「&& と & の評価順序の違い」は記号が字句解析で落ちてキーワード側が働かず、意味側だけの順位も混ぜ方で押し下げられた。「人間の感覚の限界」のような抽象的な質問も同じで、キーワードが効かない質問はハイブリッドで少し損をする。
もうひとつ、MCP 経由で Claude にハイブリッドで検索させたときに見えた副作用がある。ある語の定義を聞いたら、上位 10 件のうち 1 件が別の資料の巻末広告だった。書名にその語を含んでいるだけのページで、内容は無関係である。キーワード一致は「語があれば上がる」ので、こういう釣られ方をする。Claude はそれをノイズと判断して表から外していたが、検索基盤の段階では混ざっている。
もうひとつの落とし穴: 物差しがずれていた
この実験の直前に、別の修正(OCR で脚注が消えていた問題)のために全資料を再登録して再 OCR した。その後 Golden セットを測ったら hit@1 が 0.225 に落ちて見えた。
検索が壊れたのかと思ったが、検索画面で期待の資料を引くと、期待のページの 3 ページ後ろに正解の内容がある。再登録で原本の先頭ページ数が変わり、入力順のページ番号が資料ごとに一定量(+1 から +8)ずれていたのだ。Golden セットの「期待ページ」は前回の登録時の番号なので、全部外れて見えた。
幸い期待には印刷ページ番号(原本に印刷された番号)も持たせてあり、これは再登録しても変わらない。印刷ページ番号から新しい入力順のページを引き直したら元の値に戻った。前回「最初の数回は物差しのほうを疑う」と書いたが、物差しは作ったあとも、資料側の操作でずれる。
費用でどう判断するか
| S3 Vectors | OpenSearch Serverless | |
|---|---|---|
| 月額 | 1 ドル未満 | 約 350 ドル(2 OCU、待機レプリカ無し) |
| 精度(意味検索) | 同じ | 同じ |
| 速度 | 同じ | 同じ |
| ハイブリッド検索 | 不可 | 可(hit@1 +6 問 / 40 問) |
個人利用なら S3 Vectors のままでよい。ハイブリッドの +6 問に月 350 ドルは釣り合わない。利用者が数百人になって固定費が薄まるなら、OpenSearch にしてハイブリッドを使う価値が出る。
中間の選択肢もある。キーワード検索だけをサーバー側に持って(SQLite の全文検索など)、ベクトル検索の結果と自分で混ぜる方法だ。固定費ゼロで同じ効果が狙えるので、次に試すならこちらになる。
実験用の OpenSearch は測り終えて 45 分で壊した。費用は 0.5 ドル未満。壊したあとに検索画面の候補から消すのに設定ファイルを手で直すのが面倒だったので、サーバー起動時に Bedrock の Knowledge Base 一覧を見て、名前が paperlake で始まる本番以外の KB を候補に自動で足すようにした。次に比較したくなったら、Terraform で作って再起動するだけで画面に「すべての基盤・方式で比較」が出る。
まとめ
- 同じ資料・同じチャンク・同じ埋め込みなら、索引を S3 Vectors に置いても OpenSearch に置いても精度は変わらず、速度も変わらない。往復時間は索引ではなく Bedrock 側が支配する
- OpenSearch の価値は速さではなく、ハイブリッド検索が使えること。記号名・コマンド名・固有の言い回しを含む質問で効き、40 問中 6 問が 1 位に上がった
- 代わりにキーワードが効かない質問で少し損をし、語を含むだけの無関係なページに釣られる
- 月 350 ドルの固定費は個人利用では釣り合わない。キーワード検索を自前で足す道が次の候補
- 比較実験はインフラを Terraform の変数で横に立て、測ったら壊す。索引作成の 403 は権限ではなく
x-amz-content-sha256の欠落だった - Golden セットは資料を再登録するとページ番号がずれる。印刷ページ番号を持たせておくと復元できる
コメント