前々回で作った paperlake は、手元の GPU で紙資料を OCR し、S3 と Bedrock Knowledge Base と S3 Vectors で索引を作って、Claude Code から MCP で検索する構成だった。前回、図の扱いを試しているうちに気づいたことがある。Bedrock 上の Claude だけで、Claude Code と同じ品質の回答が作れる。だとすれば、外に出ている経路をなくして、機密資料のナレッジベースを「自社拠点 + AWS の閉域」だけで運用できるはずだ。今回はその構成を整理する。
いま外に出ている経路は 2 つ
RAG の部分(S3 → Knowledge Base → S3 Vectors)はすでに AWS の中で完結している。外に出ているのは次の 2 つだけである。
- OCR を動かす GPU サーバー(自社拠点。これは閉域の内側と言える)
- 検索結果を読んで答えを作る Claude Code(Anthropic API に出る)
2 を Bedrock の Claude に置き換え、1 を拠点に置くか AWS に置くかで 2 案に分かれる。
前提として確かめたこと
構想を書く前に、確かめておくべきことが 3 つあった。
Bedrock の Claude だけで答えが作れるか。 Knowledge Base の検索結果(本文と、図のキャプション・図中の文字)を Bedrock の Claude Sonnet 4.6 に渡し、技術資料のシーケンス図を Mermaid で再構成させた。参加者 4 局、信号の連鎖 6 種の向きがすべて原図と一致した。1 問あたり入力 4,100 トークン・出力 850 トークン、約 10 秒、約 $0.03。Claude Code でやったときと同じ品質である。
なお、Bedrock コンソールの「テスト」画面(RetrieveAndGenerate)で同じことを頼むと箇条書きに戻ってしまう。あれは生成プロンプトが固定で、図を描くような指示が通らない。閉域運用では、検索(Retrieve API)と生成(InvokeModel)を自前のプロンプトでつなぐ数十行のアプリを持つのが本筋だ。
import boto3
from anthropic import AnthropicBedrock

rt = boto3.client("bedrock-agent-runtime", region_name="ap-northeast-1")
res = rt.retrieve(knowledgeBaseId=KB, retrievalQuery={"text": question},
                  retrievalConfiguration={"vectorSearchConfiguration": {"numberOfResults": 4}})
excerpts = "\n\n".join(r["content"]["text"] for r in res["retrievalResults"])

client = AnthropicBedrock(aws_region="ap-northeast-1")
msg = client.messages.create(
    model="jp.anthropic.claude-sonnet-4-6", max_tokens=3000,
    messages=[{"role": "user", "content": f"<excerpts>\n{excerpts}\n</excerpts>\n\n{question}\n抜粋だけを根拠に答えること。"}],
)
S3 Vectors は閉域に置けるか。 ここが唯一の懸念だった。S3 Vectors は 2025 年に出た新しいサービスで、PrivateLink 対応を私は把握していなかった。調べると対応済みで、サービス名は com.amazonaws.<region>.s3vectors。エンドポイントポリシーで特定のベクトルバケットへの QueryVectors / GetVectors だけを許可でき、Direct Connect や VPN 経由でオンプレからも使える。これで穴がなくなった。
データがどこに行くか。 Bedrock は入力を学習に使わず、データはリージョン内に留まる。推論プロファイルを jp. 系(東京・大阪)にすれば国内に固定できる。逆に global. 系は海外リージョンにルーティングされうるので、機密資料では使わない。ベンチで global. を使っていた箇所は直す必要がある。
共通部分
案 A でも案 B でも同じ部分を先に書く。
| 要素 | 内容 |
|---|---|
| 保管 | S3 バケット。バケットポリシーで aws:SourceVpce 以外を拒否。SSE-KMS |
| 索引 | Bedrock Knowledge Base(Titan Text Embeddings v2)+ S3 Vectors。Knowledge Base は自前の VPC を持たず、サービス側が S3 と S3 Vectors にアクセスする |
| 生成 | Bedrock の Claude(jp. 推論プロファイル)。Retrieve で取った抜粋を自前のプロンプトに入れて InvokeModel |
| 入口 | 社内アプリ。VPC 内の ALB + Cognito か、社内ネットワーク限定 |
| 経路 | VPC エンドポイント: s3、s3vectors、bedrock-runtime、bedrock-agent-runtime。インターネットゲートウェイと NAT なし |
| 権限 | 取り込み用ロール(docs/ への Put/Delete と StartIngestionJob だけ)と参照用ロール(Retrieve と InvokeModel だけ) |
| 監査 | CloudTrail。S3 Vectors は NetworkActivity イベントで見える |
案 A: OCR は拠点のローカル GPU
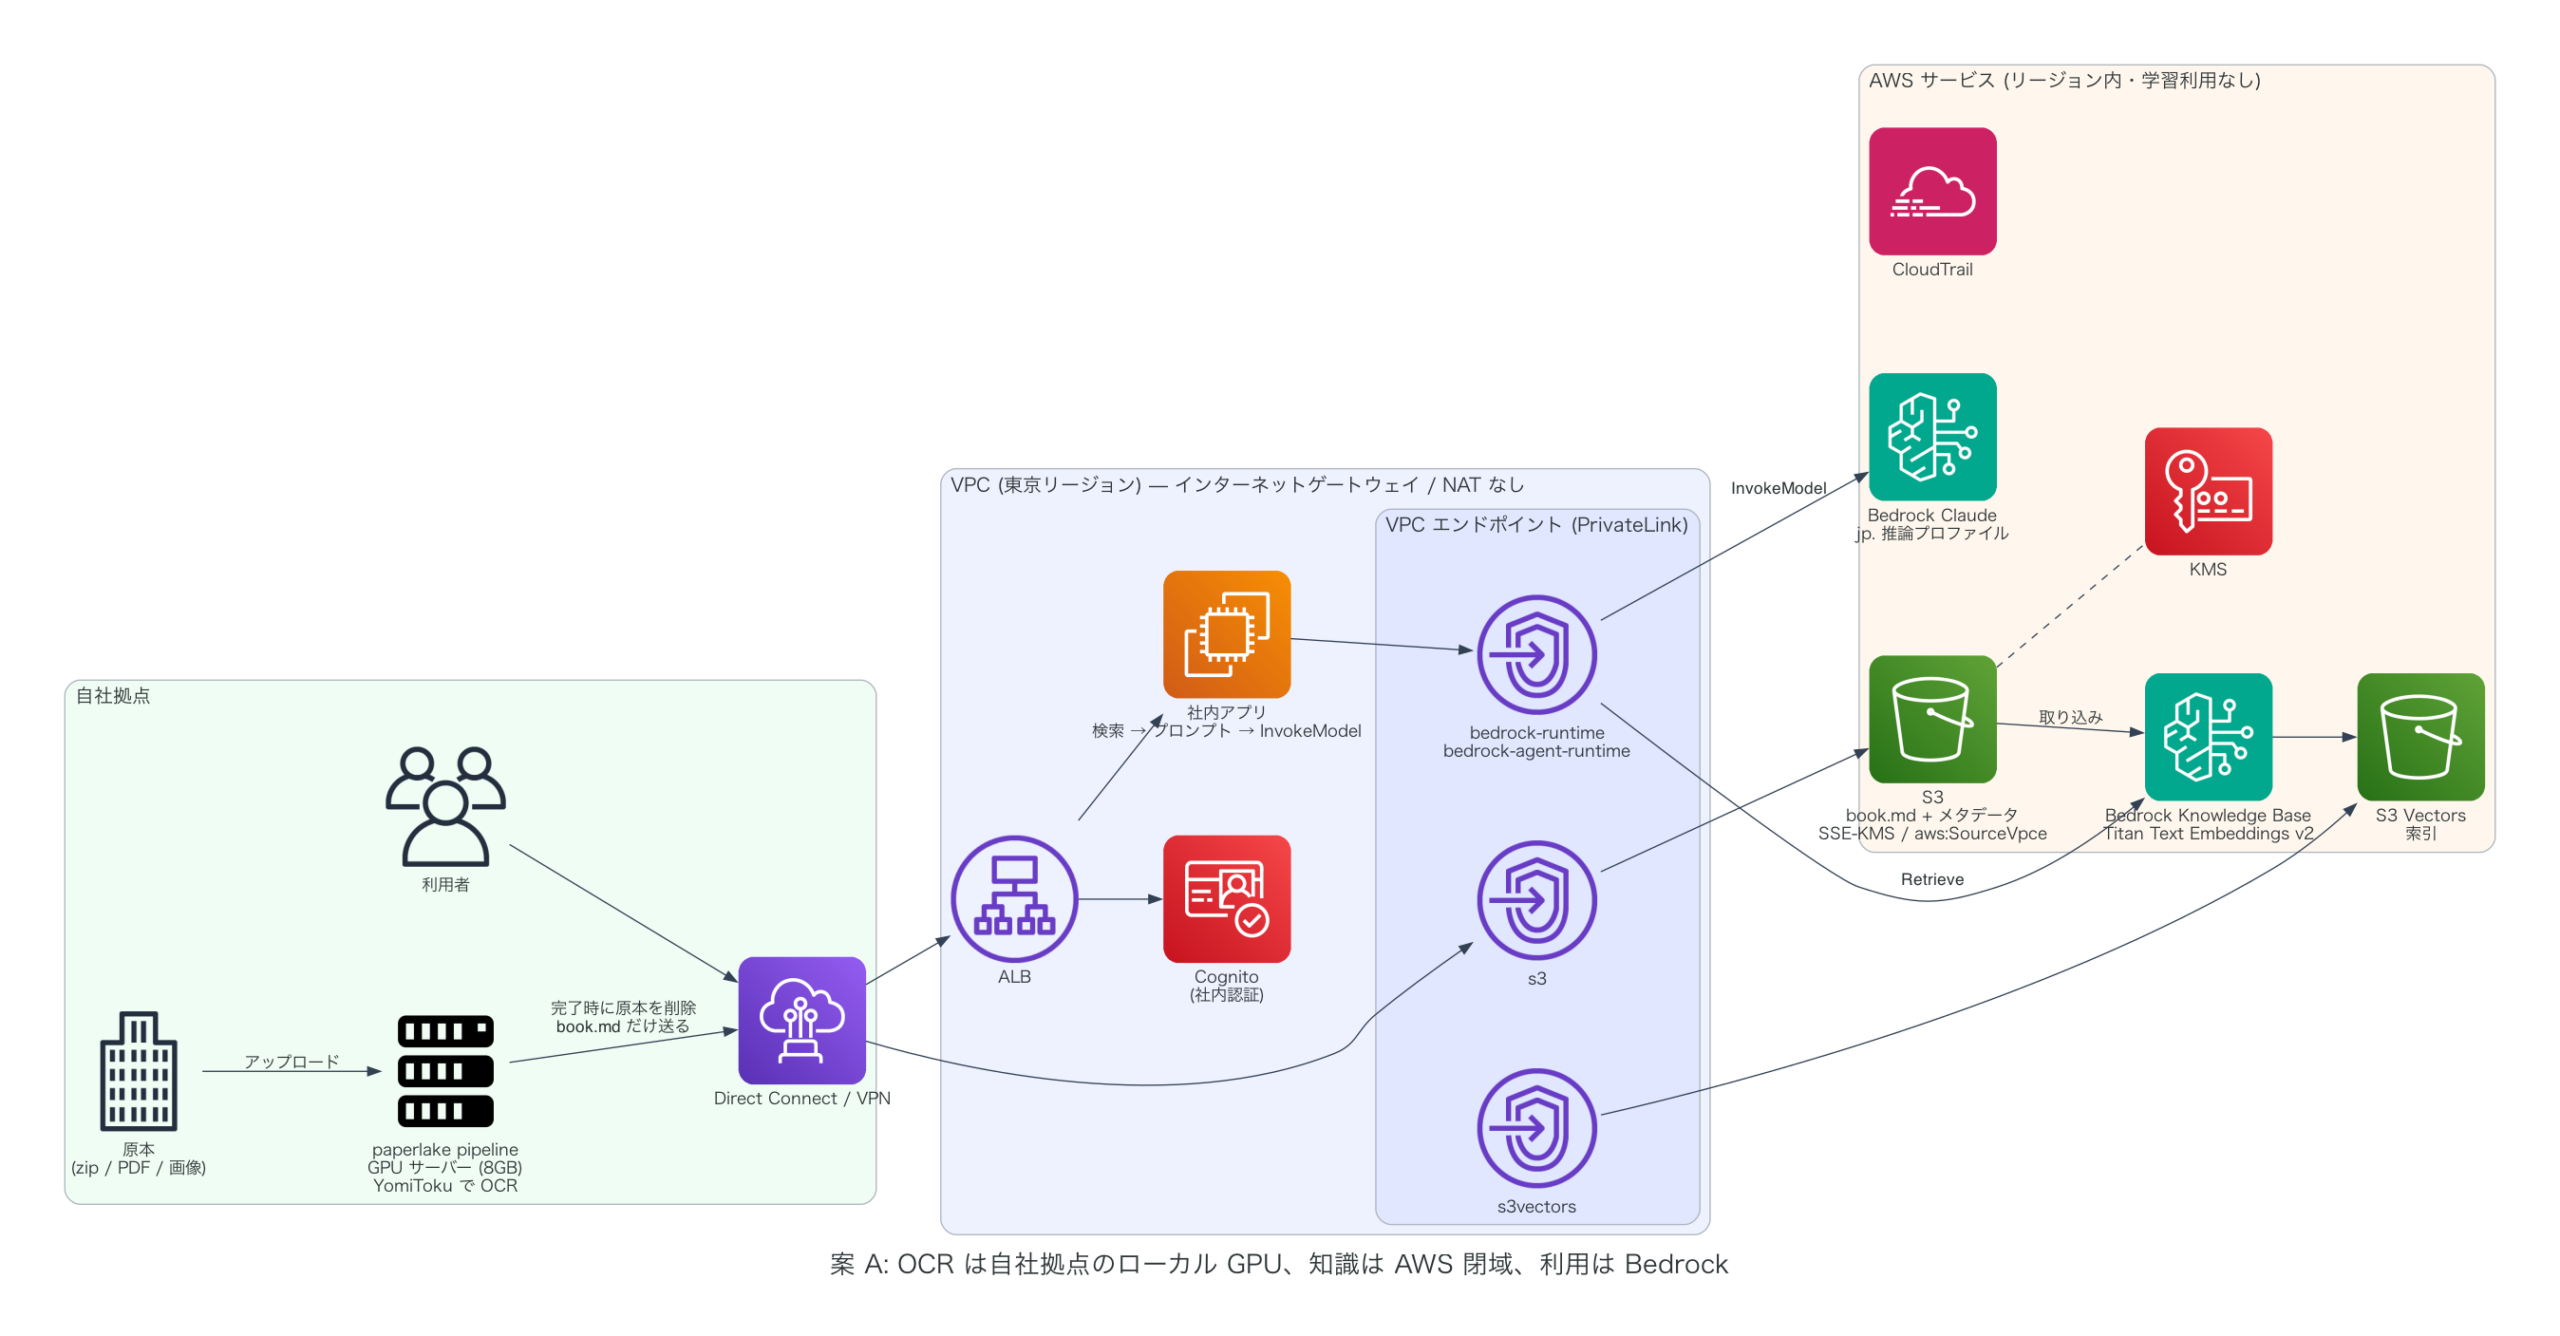
今の paperlake そのものである。GPU サーバーの Docker コンテナが OCR し、完了時に Markdown とメタデータだけを S3 に置いて取り込みジョブを起動する。原本とページ画像は拠点から出ない。OCR 完了時に削除するので、拠点に残るのもテキストだけだ。AWS への経路は Direct Connect か VPN で、S3 の VPC エンドポイントに向ける。
GPU は 8GB のもので足りる。日本語特化の OCR は VRAM 2.6GB、1 ページ 1 秒で、ジョブは 1 枚の GPU で直列に流す。
- 資料の露出は最小。AWS に上がるのは OCR 済みテキストのみ
- 費用は GPU サーバーの電気代と、AWS が月 $1 未満(索引)+ 生成が 1 問数セント
- 拠点の GPU サーバーの面倒を見る必要がある。故障時は OCR が止まる(索引と検索は影響なし)
案 B: OCR も AWS
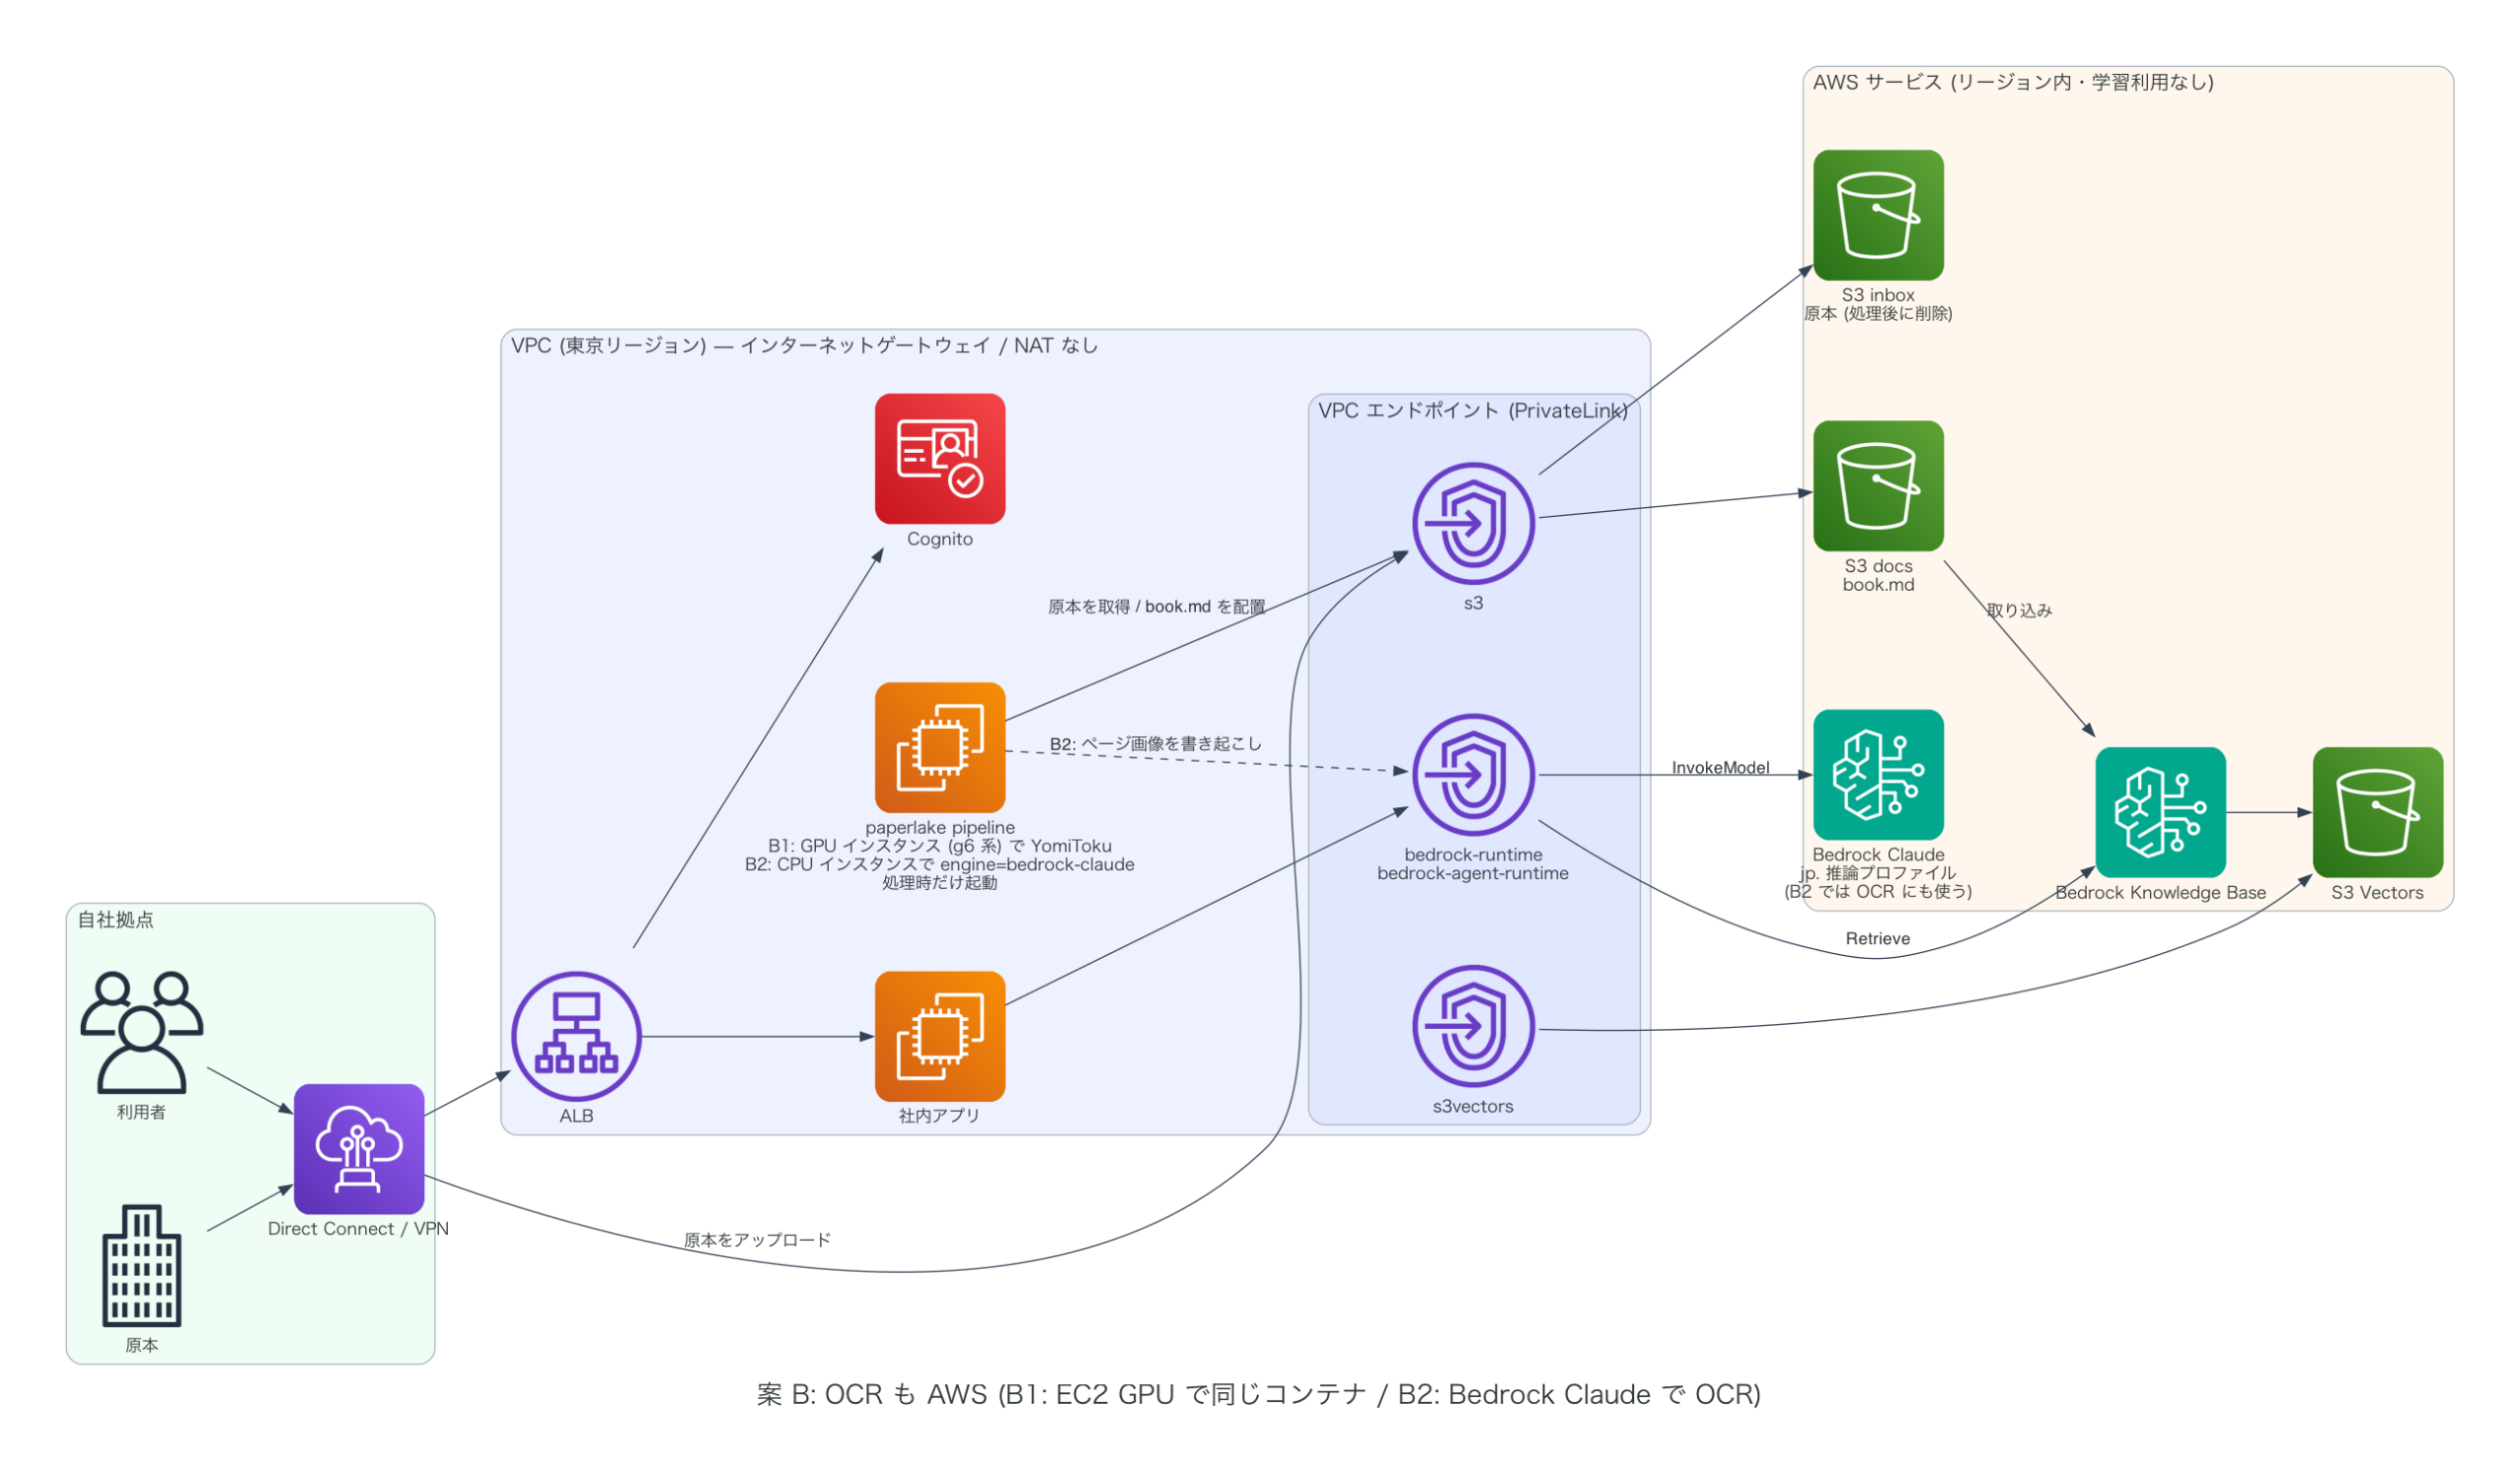
拠点に GPU 機を置きたくない、複数拠点から取り込みたい、という場合である。paperlake のパイプラインは OCR エンジンを差し替えられるので、置き方は 2 通りある。
B1: EC2 の GPU インスタンスで同じコンテナを動かす。 g6.xlarge(L4 24GB)などに同じ Docker イメージを載せる。処理するときだけ起動して終わったら止める運用にすると、400 ページの資料 1 冊が 10 分弱で、インスタンス代は 1 冊 $0.2 程度。精度は拠点と同じである。
B2: Bedrock の Claude に OCR させる。 GPU が要らない。自作の業務文書ではページ画像の書き起こしが正確だったが、出版物のページは著作物として書き起こしを断られるので、社内文書専用になる。費用は概算で 1 ページあたり Haiku 4.5 で $0.005、Sonnet 4.6 で $0.02。縦書きやルビの精度は日本語特化 OCR ほど検証していない。
どちらも原本のページ画像が AWS(閉域内)に上がる点が案 A と違う。処理後に削除する運用は同じにできる。
比較と推奨
| 案 A: OCR ローカル | 案 B1: EC2 GPU | 案 B2: Bedrock OCR | |
|---|---|---|---|
| 原本の置き場所 | 拠点のみ | AWS 閉域(処理中のみ) | AWS 閉域(処理中のみ) |
| 縦書き・ルビ | ○ | ○ | △(未検証) |
| 出版物の取り込み | ○ | ○ | ×(拒否される) |
| 1 冊(400 頁)の OCR 費用 | 電気代のみ | 約 $0.2〜1 | $2〜8 |
| 拠点側の設備 | GPU サーバー | 不要 | 不要 |
| paperlake の変更 | なし | 配置先だけ | エンジン選択だけ |
推奨は案 A で、GPU 機を持たない組織や複数拠点の運用が要るときに B1 に移す。B2 は「社内文書だけ、量が少ない」場合の最短経路である。
費用で言うと、閉域化で新たに固定費になるのは VPC エンドポイントの時間課金(インターフェイス型 3 つで月 $25 前後)だけで、それが月額の大半を占める。索引は月 $1 未満、取り込みは 400 ページで $0.005、生成は 1 問 $0.03 程度。
残っている作業
- VPC、VPC エンドポイント、バケットポリシーの Terraform 化
- 推論プロファイルの
jp.系への統一 - 取り込み用 IAM ユーザーをロールに置き換える(EC2 ならインスタンスプロファイル、拠点なら IAM Roles Anywhere)
- 社内アプリの雛形(上のスニペットの整形版)
- Web UI の認証
- 案 B1 の起動・停止の自動化
paperlake の位置づけは、これで「ローカル OCR で安く読める」から「閉域で機密資料のナレッジベースが作れる」に変わった。OCR は手元、知識は AWS 閉域、利用は Bedrock。一日の試行錯誤の末に、構成として一貫した形になったと思う。
コメント