紙の資料をスキャンして OCR にかけ、Markdown にして検索できるようにし、Claude から MCP で引く。この一連を paperlake という名前で 1 週間ほど作ってきた。検索基盤は Amazon Bedrock Knowledge Base (Titan Text Embeddings v2 + S3 Vectors) から始め、途中で OpenSearch Serverless と比べ、最後は手元の GPU サーバーに置いた ruri-v3 + OpenSearch + 再ランク に落ち着いた。
この記事でプロジェクトを締める。結論を先に書くと、構造は実用になったが、リポジトリは公開しない。扱っているのがスキャン画像と OCR テキスト、つまり著作物だからだ。一方で、RAG の各段を自分の手で置き換えて測れたことは、学習としては大きかった。その両面を残しておく。
これまでの記事 (8 本) は末尾にまとめた。
何を作ったか
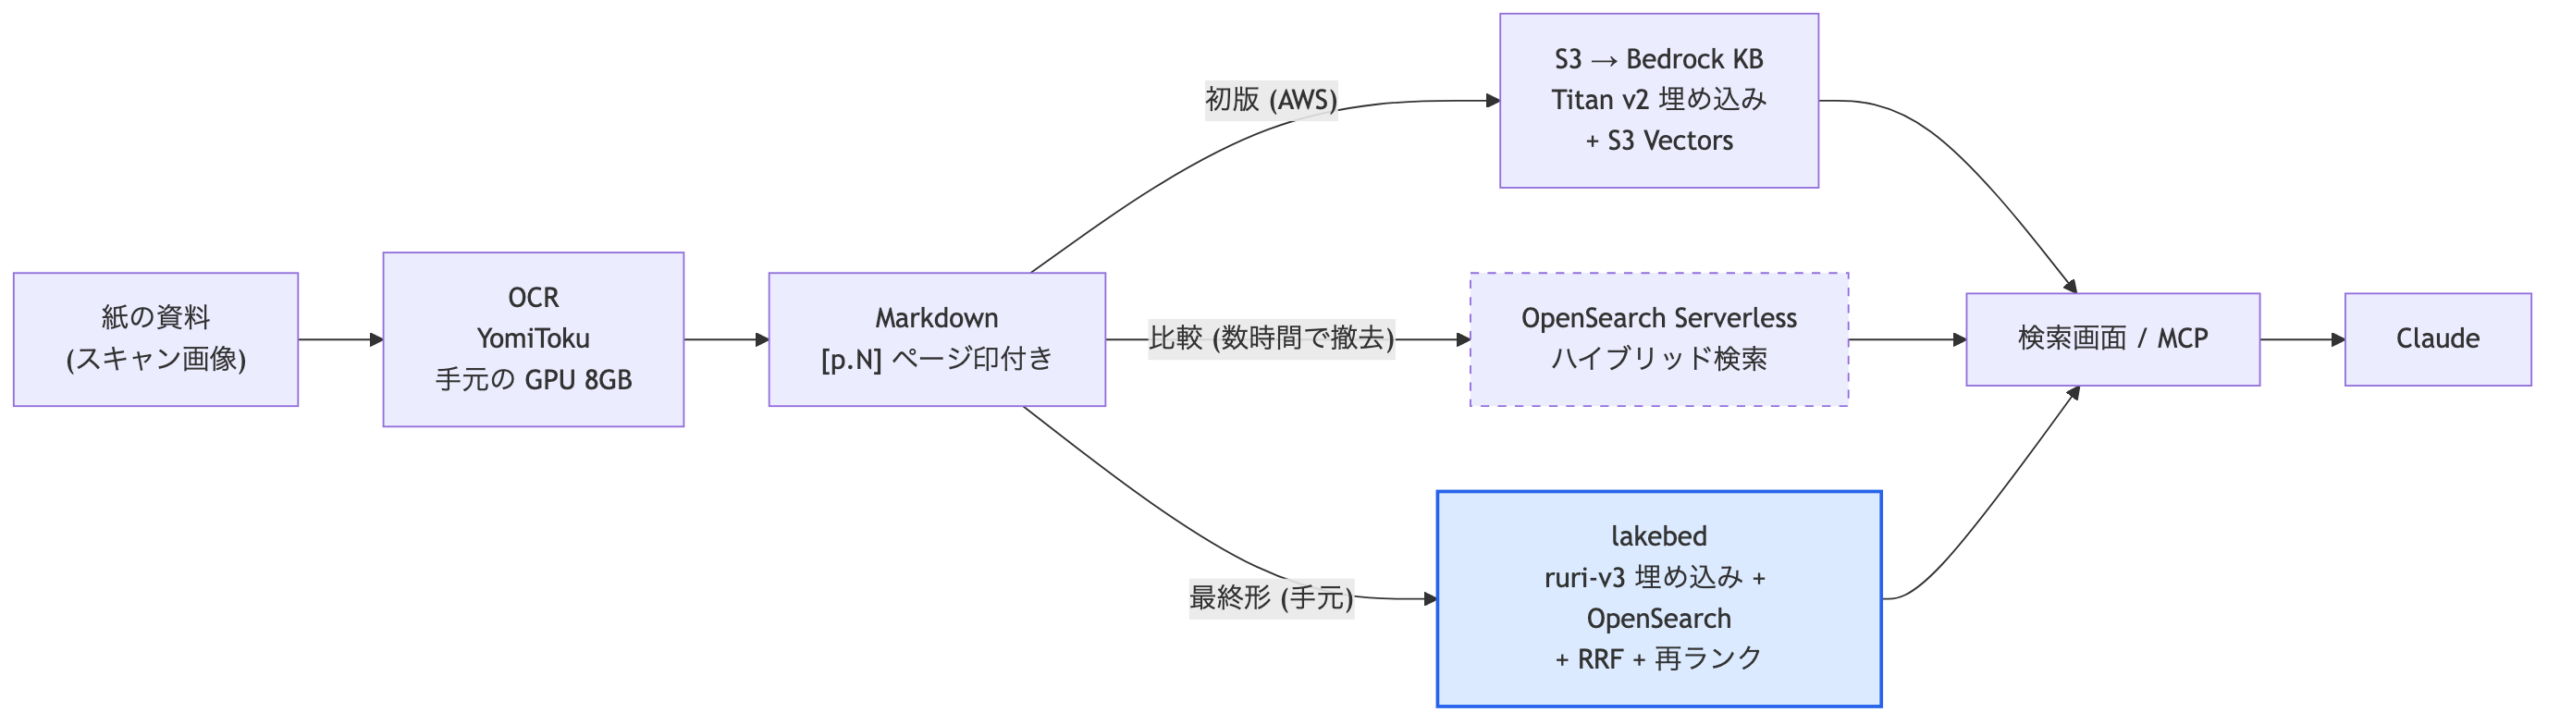
- OCR: YomiToku を 8GB の GPU で動かす。縦書きの資料を 432 ページ 7 分で読む。本文だけでなく柱・ノンブル・注も役割ごとに分かれて出てくるので、それを使って
[p.12 | 印刷 34]のようなページ印付きの Markdown を作る - 検索基盤: 同じ Markdown を複数の基盤に入れ、検索画面で並べて比べられるようにした。基盤は起動時に自動で見つけて候補に出す
- MCP: Claude Code から
search_documentsで当たりを取り、get_pagesで前後のページを読み、資料名と印刷ページを添えて答える
資料は 23 冊、索引にすると約 9,600 チャンクになった。
検索基盤の移り変わりと、測った結果
最初に作ったのは物差しだった。資料ごとに「この質問ならこのページが正解」という組を 40 問用意し (Golden セット)、上位 k 件に正解が入るかを hit@k で測る。途中から、同じ 40 問を別の言い回しにした言い換え版も足した。本文の語をそのまま使った質問だけで測ると、キーワード検索が不当に強く見えるからだ。
| 基盤 | 方式 | 元の 40 問 hit@1 / hit@5 / MRR | 言い換え版 hit@1 / hit@5 / MRR | 1 問の所要時間 |
|---|---|---|---|---|
| Titan v2 + S3 Vectors (Bedrock KB) | 意味 | 0.400 / 0.825 / 0.570 | 0.300 / 0.600 / 0.410 | 299 ms |
| Titan v2 + OpenSearch Serverless (Bedrock KB) | ハイブリッド | 0.550 / 0.875 / 0.690 | ― | 321 ms |
| ruri-v3-310m + OpenSearch (手元) | ハイブリッド | 0.575 / 0.875 / 0.688 | 0.325 / 0.700 / 0.469 | 97 ms |
| ruri-v3-310m + OpenSearch (手元) | ハイブリッド + 再ランク | 0.725 / 0.925 / 0.798 | 0.425 / 0.725 / 0.554 | 400 ms |
この表から読み取れたことは 3 つある。
1. 索引の置き場所では差が出ない。 S3 Vectors と OpenSearch で同じ Titan の埋め込みを使うと、意味検索の成績はほぼ同じだった。差が出たのはキーワード検索を混ぜたハイブリッドにしたときで、これは置き場所ではなく方式の差だ。
2. 効いたのは日本語に強い埋め込みと、再ランク。 手元に移して ruri-v3 (日本語特化の埋め込みモデル) に替え、さらにクロスエンコーダで上位 20 件を並べ直すと、hit@1 は 0.400 から 0.725 まで上がった。再ランクで 1 問 0.4 秒かかるが、人が読む用途なら気にならない。
3. 言い換えにはまだ弱い。 言い換え版では、キーワード検索だけだと hit@1 が 0.65 から 0.20 まで崩れた。取りこぼした正解を追うと、意味検索の 18〜60 位に沈んでいた。再ランクは候補に入っていないものを拾えないので、候補を増やしても誤りが増えるだけだった。伸びしろは埋め込み側にある。
ハイブリッドの混ぜ方は、Reciprocal Rank Fusion (RRF) にした。スコアの尺度が違う意味検索とキーワード検索を、順位だけで足し合わせる。実装はこれだけだ。
AWS から手元に移した理由
精度だけなら、OpenSearch Serverless のハイブリッドでもかなり戻った。それでも手元に移したのは費用と、資料を外に出さないためだ。
- OpenSearch Serverless は固定費が重い。 最小構成でも 1 時間あたり約 0.5 ドルかかり、月に直すと数百ドルになる。個人の 23 冊には見合わないので、比較が終わった数時間後に撤去した
- S3 Vectors 構成は安い。 9 月の請求で、埋め込みと検索にあたる Bedrock の利用料は 0.59 ドル、S3 は 0.38 ドルだった。同じアカウントのほかの用途も含んだ額なので、paperlake の分はこれ以下になる。初版として試すなら、今でも一番手軽な構成だと思う
- 手元の構成は追加費用ゼロ。 OCR 用にすでにある GPU サーバーの上で、埋め込み・OpenSearch・再ランクがすべて動く。GPU の使用量は常駐で約 2 GB だ
もう一つの理由は、資料の本文をクラウドに置かずに済むことだ。スキャン画像と OCR テキストは私的使用の範囲で複製しているものなので、置き場所は少ないほうがいい。
詰まったのは検索ではなく、周りだった
検索の精度は表のとおり素直に上がった。手間取ったのはむしろ運用で、どれも「サーバーを再起動したら何かが消える」という形で現れた。
起動の順番に頼らない
サーバーを再起動すると、検索画面の候補から手元の基盤が消えていた。paperlake の Web アプリは起動した瞬間に一度だけ、手元の検索 API に候補を問い合わせていた。一方の API はモデルの読み込みに 45 秒かかり、その間はポートを開けていなかった。問い合わせは「接続拒否」で失敗し、候補から外したまま二度と探しに行かなかった。
systemd や Docker Compose で起動順を制御する手もある。ただ、それで守れるのは全部が同時に立ち上がる最初の 1 回だけだ。デプロイで API だけを再起動した場合や、落ちて自動復帰した場合には効かない。そこで、呼ぶ側が「届かなかった相手を覚えておき、後で探し直す」ようにした。
呼ばれる側の API も、モデルを別スレッドで読み込み、ポートはすぐ開けるようにした。この 2 つを入れたあと、電源を落として Wake-on-LAN で起こす試験を 2 回した。どちらも起動から約 1 分半で、手を触れずに候補が戻った。
修正が生んだ不具合: GPU にモデルが二重に載る
モデルの読み込みを裏のスレッドに回したら、別の問題が出た。読み込みの途中に検索が届くと、1 プロセスで GPU を 5 GB 使い、再ランクの途中でメモリ不足になった。普段は 2 GB だ。
原因は functools.lru_cache だった。初回の呼び出しが終わる前に同じ引数で呼ばれると、両方が関数本体を実行する。素の lru_cache に 5 スレッドを同時に当てると、読み込みは 5 回走った。ロックで囲んで 1 回に限った。
ある朝、全部が起動しない
別の日の再起動では、手元の検索 API も取り込みの監視も MCP も、全部が起動しなかった。ログには uv の次のエラーが 5 秒おきに 500 回以上並んでいた。
「作れない」のに「すでにある」。辿ると、~/.cache/uv はデータ用ディスクへのシンボリックリンクで、リンク先のディレクトリが前日に消えていた。リンクだけが残っていたので、uv がディレクトリを作ろうとすると「すでにある」で失敗する。動いていたプロセスは起動時にしかキャッシュを見ないので、再起動するまで誰も気付かなかった。
根本の問題は、サービスが個人のログインアカウントのホームに住んでいたことだった。ホームを整理すると、サービスが壊れる。そこで、ログインできないサービス専用のユーザーを作り、コードを /srv に移した。起動も uv を介さず、仮想環境の Python を直接呼ぶようにした。
同じ流れで、AWS の認証情報も個人のホームから /etc の下に移した。最後に、データを毎日 NAS に取るバックアップも入れた。rsync の --link-dest で、変わっていないファイルは前日分とハードリンクで共有する。初回は 5.7 GB を 1 分 45 秒、2 回目以降の増分は十数秒で終わる。
公開できないものの線引き
paperlake のコード自体は、どこにでもある形をしている。OCR を呼び、Markdown を作り、埋め込んで、索引に入れて、検索する。それでもリポジトリを公開しないのは、著作物に触れる場所が思ったより多いからだ。
- テストのデータ: 実際の資料で作りたくなる。代わりに、自作の短文で合成したページ画像を使った
- 評価セット: 質問と正解ページの組には、どうしても本文の言い回しが入る。これはリポジトリに入れず、手元にだけ置いた
- ログや PR 本文: 検索結果のチャンクを貼ると、それだけで本文の書き写しになる。載せるのは、誤り箇所の数文字までにした
- 履歴: 一度でも入れると、消しても履歴に残る。実際に、スキャン画像の zip (117 MB) を
git add -Aで拾いかけた。GitHub の 100 MB 制限で push が拒否されて気付いた
この事故のあと、push の前に必ず走る検査を入れた。禁止するパスと拡張子、大きいファイル、全履歴、それに日本語の長文の混入を見る。
日本語の文字数のしきい値は、実測で決めた。自作のファイルは最大でも 3,000 字ほどで、OCR の結果は 1 冊で 8 万〜40 万字ある。その間の 8,000 字で線を引いた。
公開できるのは、こうした記事と、コードの抜粋と、測った数字だ。この記事にも、資料の名前や本文は一切入れていない。
RAG の学習として得たもの
作る前は、RAG は「ベクトル DB に入れて近いものを取ってくる」ものだと思っていた。作ってみると、段ごとに別の問題があった。
- 前段 (OCR) がすべてを決める。 柱・ノンブル・注を本文と分け、ページ印を付けておかないと、どんなに検索が良くても「何ページに書いてあるか」を答えられない
- 物差しが無いと何も言えない。 Golden セットと hit@k を先に作ったので、基盤を替えるたびに同じ 40 問で比べられた。言い換え版を足すまで、キーワード検索を過大評価していた
- 置き場所より、埋め込みと並べ直し。 マネージドのベクトル DB を替えても精度は変わらない。変わるのは、日本語に合った埋め込みと、最後の再ランクだった
- 運用は RAG の外にある。 再起動・起動順・ユーザー・認証情報・バックアップ。検索の精度とは関係なく、ここが崩れると全部が使えなくなる
AWS の Bedrock Knowledge Base は、埋め込み・索引・検索を自分で組まずに試せる入口として優秀だった。そこで物差しを作ってから手元に移したので、何が効いて何が効かないかを、実際の数字で確かめながら進められた。
シリーズの記事
- 縦書き資料をRAGにする前段を作る ― 8GB GPUのYomiTokuで432ページ7分、paperlakeができるまで
- 図は VLM に読ませるべきか ― ローカル VLM で図を Mermaid 化する試験と、文字だけで図が再構成できた話
- 機密資料のナレッジベースを AWS の閉域だけで回す ― OCR ローカル案と完全 AWS 案
- 紙のページはどうやって文字になるのか ― YomiToku に画像を渡してから Markdown が出るまで
- Claude Code から資料を引く仕組み ― paperlake の MCP サーバーは 40 行でできている
- 検索は当たっているのか ― RAG に「物差し」を作る: Golden セットと hit@k
- S3 Vectors か OpenSearch か ― 同じ 40 問で測ったら、索引では差が出ずハイブリッドで 6 問上がった
- 検索基盤を手元に置いたら AWS より当たった ― ローカル埋め込み + OpenSearch + 再ランクで RAG を組み直す
- 公開できない RAG を作り切って分かったこと (この記事)
コメント