eBPF は「Linux カーネルの中で、検証済みの小さなプログラムを動かす仕組み」である。言葉では何度も聞いていたが、実際に何が見えて何が見えないのかは、手を動かさないと分からない。そこで Zabbix 風の Linux ダッシュボードを eBPF で作り直す実験 eBPFLens を始め、5 本の PR で形にした。この記事は、そこで得た実測値とコードを材料に、eBPF の基本を整理したものである。
試した環境は次のとおり。
- Ubuntu 26.04.1 LTS、カーネル 7.0.0-34-generic、8 コア、RTX 2070(自宅の検証サーバー)
- Go 1.26 + cilium/ebpf v0.22.0、clang 21
- フロントは React + TypeScript
eBPFとは
eBPF は、Linux カーネルに用意された カーネル内の実行環境 である。カーネルを再ビルドせず、カーネルモジュールも書かずに、カーネル内の決まった場所(フック)に自分の処理を差し込める。名前の由来は 1990 年代初めの Berkeley Packet Filter(tcpdump のパケットフィルタ)だが、今はパケットに限らず、スケジューラ、システムコール、ファイル、メモリ、ユーザー空間の関数呼び出しまで対象が広がっていて、名前は略語というより固有名詞になっている。
流れは次の図のとおりである。
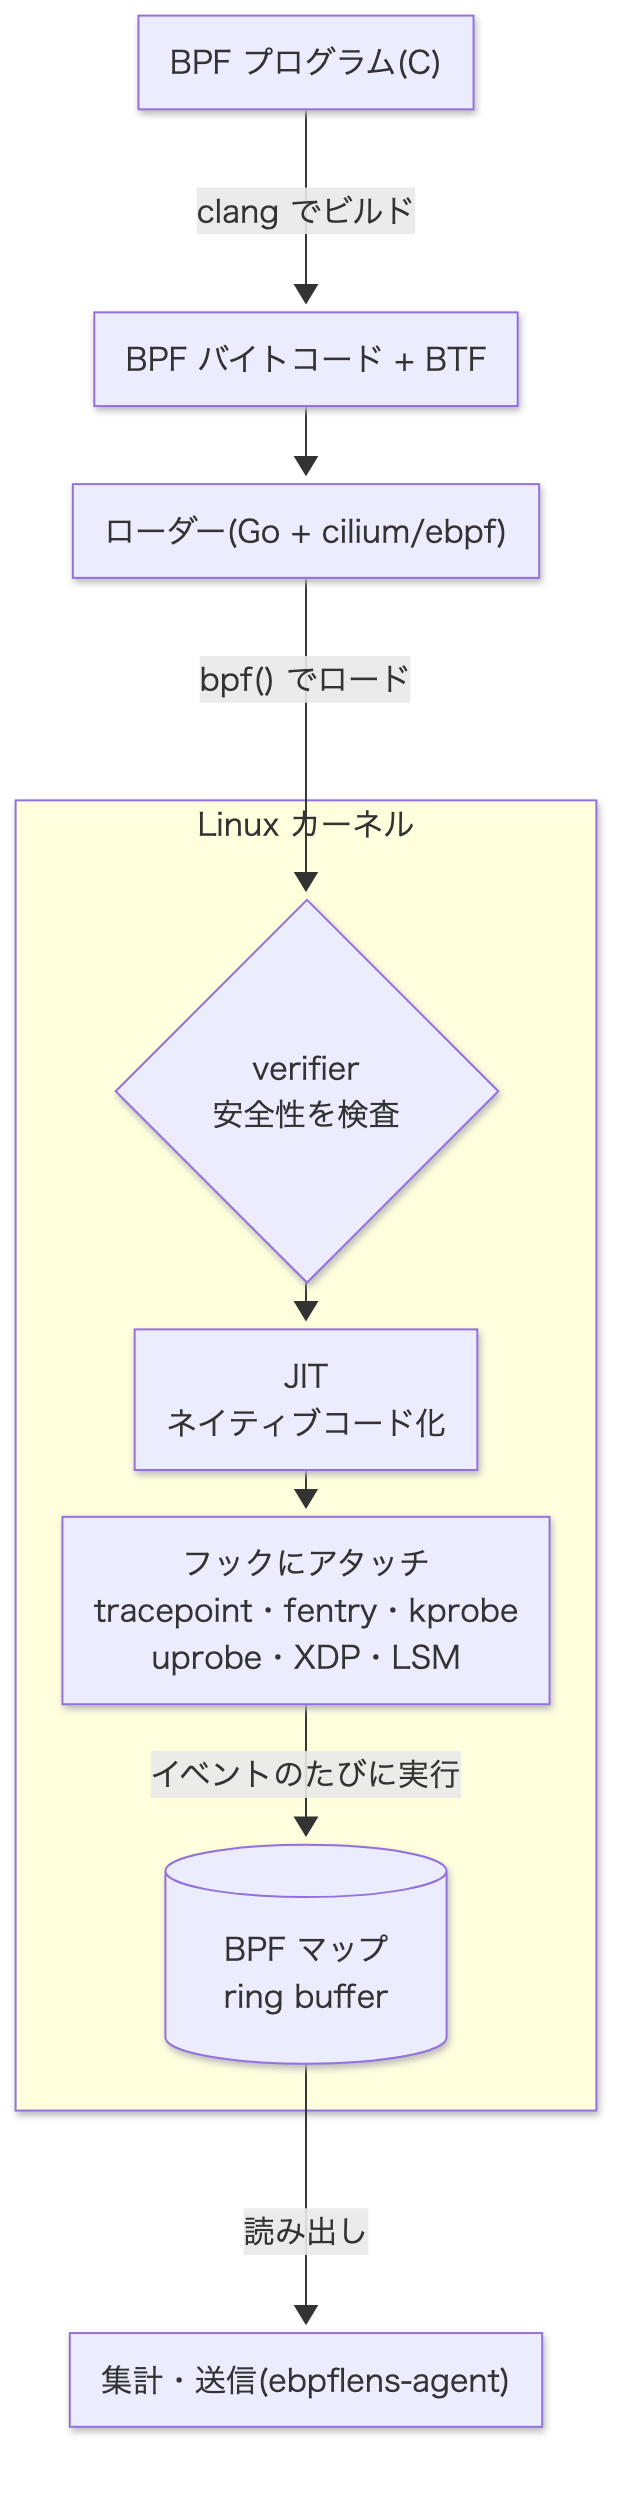
- C で BPF プログラムを書き、clang で BPF バイトコードにする。 型情報(BTF)も一緒に埋め込まれる
- ローダーが
bpf()システムコールでカーネルに渡す。 eBPFLens では Go の cilium/ebpf を使った - verifier が安全性を検査する。 範囲外のメモリアクセス、終わらないループ、NULL チェック漏れがあると、ロードそのものを拒否する。カーネルを落とすプログラムは、そもそも入れられない
- JIT でネイティブコードにして、フックにアタッチする。 tracepoint(カーネルの計装点)、fentry/kprobe(カーネル関数の入口)、uprobe(ユーザー空間の関数)、XDP(NIC 直後のパケット処理)、LSM(セキュリティフック)などがある
- 結果は BPF マップや ring buffer に書き、ユーザー空間から読む
BCC と CO-RE
eBPF のツールを作る方式は大きく 2 つある。この違いは、最初の技術選定で一番効いた。
| BCC(Python など) | CO-RE(libbpf / cilium/ebpf / aya) | |
|---|---|---|
| BPF をコンパイルする時 | 起動のたび(実行時に clang を呼ぶ) | ビルド時 |
| 監視対象に要るもの | BCC、clang/LLVM、カーネルヘッダ | カーネルの BTF だけ |
| 配布 | ホストごとにパッケージを入れる | 単一バイナリ |
| カーネル構造体のずれ | ヘッダに合わせて毎回コンパイルし直す | ロード時に BTF を見て再配置する |
CO-RE(Compile Once – Run Everywhere)は、カーネルが自分の型情報(BTF、/sys/kernel/btf/vmlinux)を持っていることを利用する。ビルド時に「task_struct の tgid を読む」という意図を記録しておき、ロード時に実行中カーネルの BTF を見てオフセットを合わせる。だから一度ビルドしたバイナリが、構造体の並びが違う別のカーネルでも動く。eBPFLens は「エージェントを配って監視する」形を目指したので、CO-RE の Go(cilium/ebpf)を選んだ。
eBPFでできること
できることは、大きく 3 つに分けられる。eBPFLens で実際に書いたコードで見ていく。
1. カーネルの中で集計して、要約だけを持ち出す
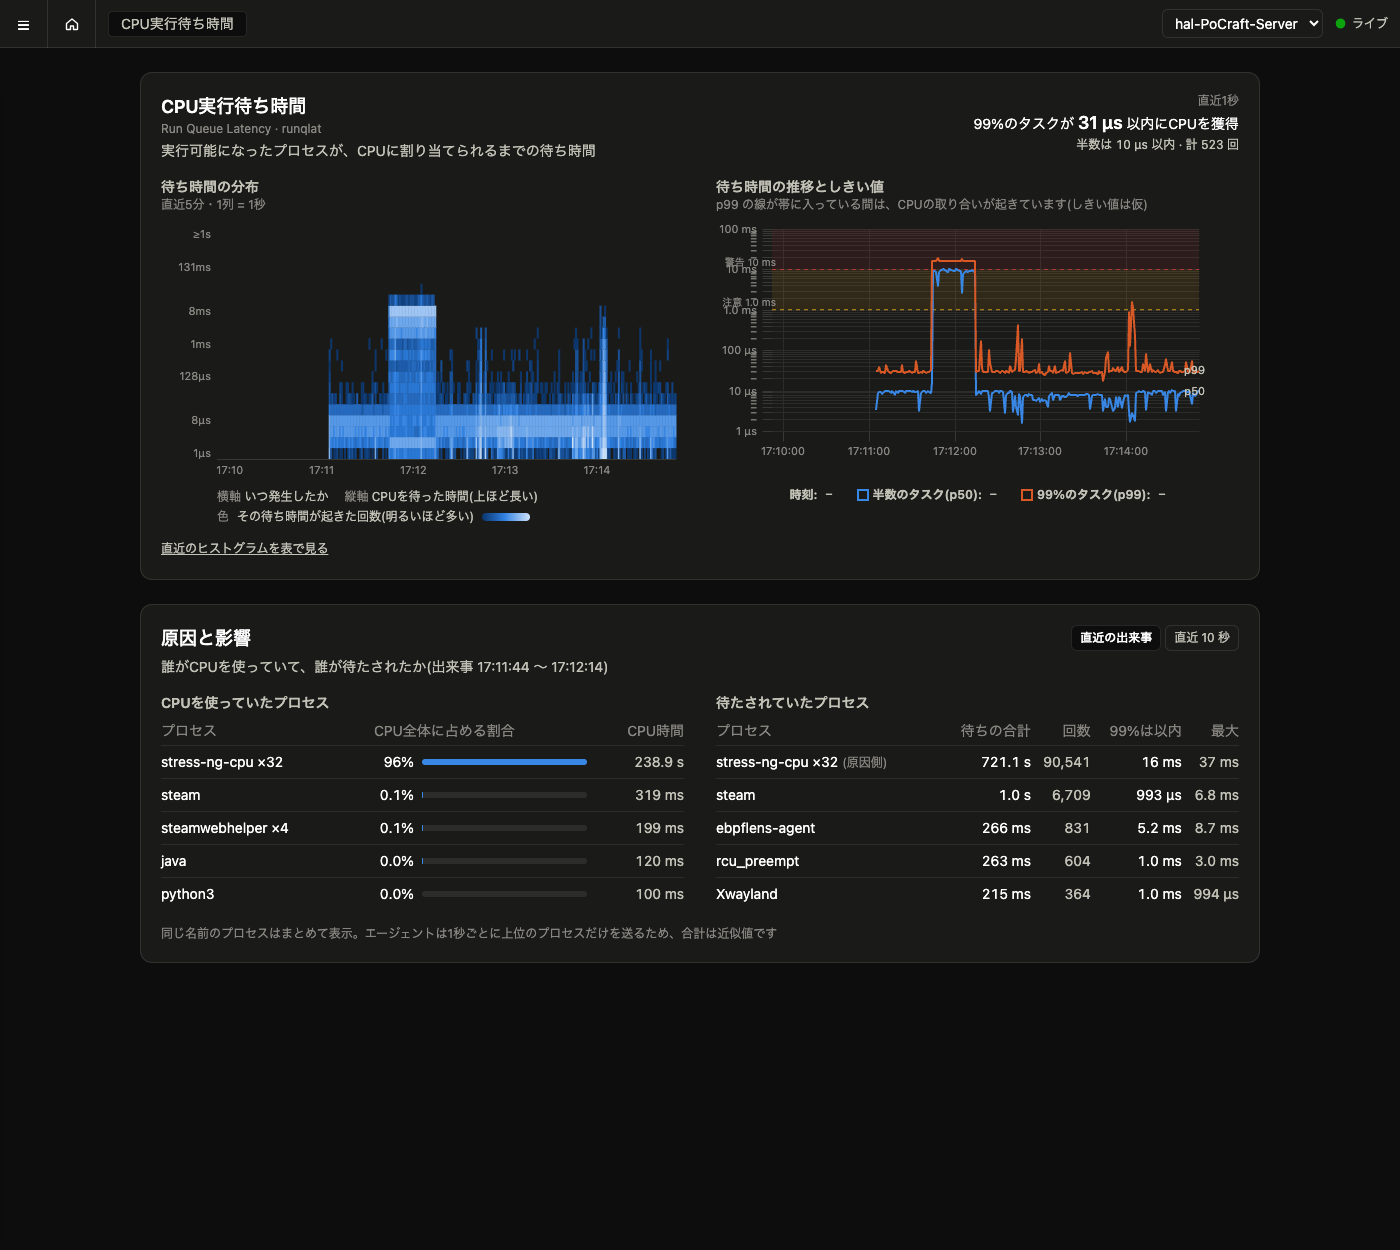
最初に作ったのは runqlat(CPU 実行待ち時間)である。タスクが起床してから実際に CPU に載るまでの待ち時間を、スケジューラの tracepoint で測る。ポイントは、1 件ずつユーザー空間に送らず、カーネル内でヒストグラムに積むことだ。スケジューラのイベントは 1 秒に数千件あるが、ユーザー空間は 1 秒に 1 回、27 個のスロットを読むだけで済む。
sched_wakeup で起床時刻を記録し、sched_switch で CPU に載った瞬間との差を log2 のスロットに数える。if (slot >= MAX_SLOTS) の境界チェックは、verifier に「配列の範囲内だ」と証明するためにも要る。書き始める前に、実行中カーネルの BTF で引数の並びを確認した。カーネル 7.0 の sched_switch は (bool preempt, prev, next, unsigned int prev_state) で、古い解説にある形とは違う。
8 コアに stress-ng --cpu 32(4 倍の過負荷)をかけると、分布の山がはっきり動いた。
| 条件 | 分布の山 |
|---|---|
| 負荷なし | 8〜15 µs |
| 4 倍の過負荷 | 8〜16 ms |
| 負荷を止めた後 | 8〜15 µs に戻る |
4 倍の過負荷なら、自分の前に 3 つほどタスクが並ぶ。EEVDF スケジューラの基本スライスは約 3 ms なので、3 ms × 3 ≈ 9 ms 待つ計算になり、山の移動と合う。
2. イベントを 1 件ずつ、取りこぼさずに拾う
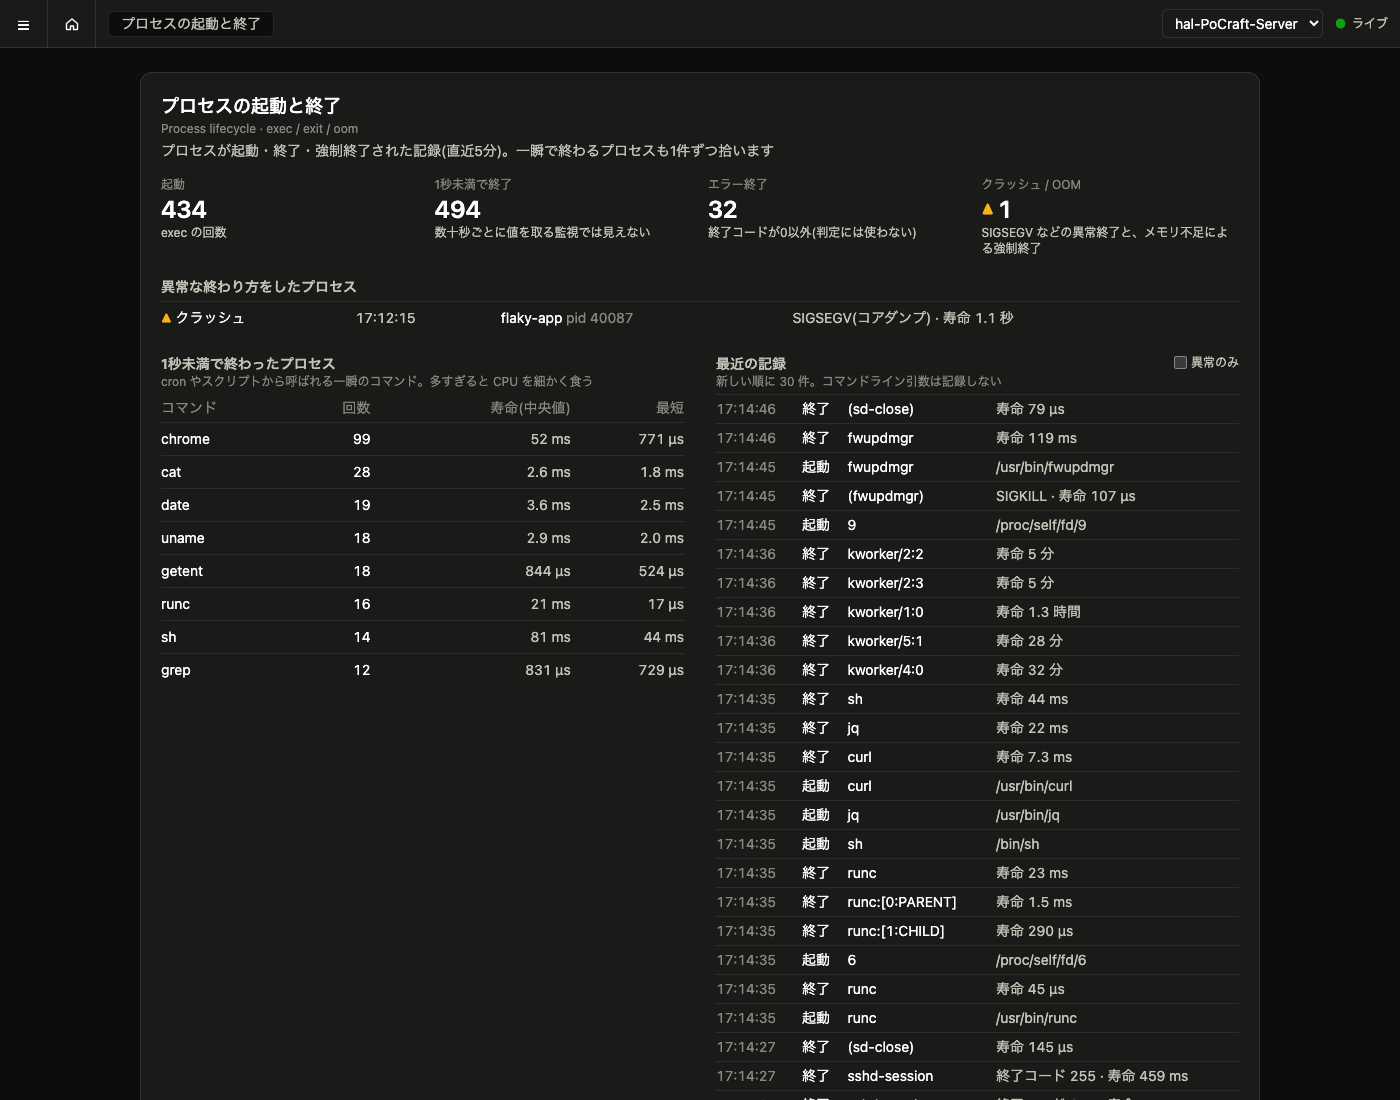
集計せずに 1 件ずつ欲しいものもある。プロセスの起動・終了・OOM kill がそうだ。こちらは ring buffer でユーザー空間に流す。
ここでもカーネル 7.0 の BTF を先に見た。sched_process_exit に group_dead という引数が増えていて、これを使うと「スレッドではなくプロセス全体が終わった」ときだけを拾える。OOM は oom_kill_process の入口に fentry で入り、強制終了されたプロセス(oc->chosen)に加えて、メモリを要求して OOM を引き起こしたプロセス(その時点の current)と、cgroup の上限によるものかどうかまで取る。
実際に拾えたもの:
| テスト | 記録された内容 |
|---|---|
/bin/true |
寿命 880 µs |
sh -c 'exit 3' |
終了コード 3 |
kill -SEGV $$ |
SIGSEGV、コアダンプあり |
systemd-run -p MemoryMax=64M の中で 300MB 確保 |
OOM kill、cgroup の上限(64MB)、直後に SIGKILL で終了 |
1ms 未満で終わるプロセスまで、1 件ずつ残る。
3. 「誰が」まで分解する
カーネルの中では、イベントがどのプロセスのものかが分かる。runqlat の sched_switch に数行足すだけで、「CPU を使っていたのは誰か(原因)」と「待たされたのは誰か(影響)」をプロセス別に取れた。
過負荷の最中に、1ms ごとに起きるだけの小さなプロセス victim-app(python3 を別名でコピーしたもの。プロセス名で見分けるため)を同居させた結果がこれである。
| プロセス | 平常時の p99 | 過負荷時の p99 | CPU 使用 |
|---|---|---|---|
| stress-ng-cpu ×32(原因) | – | 16 ms | 99.5% |
| victim-app(巻き込まれた側) | 16 µs | 1.0 ms | 0.1% |
原因が一目で分かるうえに、巻き込まれた側の待ちは占有している側より 1 桁以上小さい、ということまで見えた。すぐ寝るタスクを EEVDF が起床時に優遇するためだ。
eBPFのユースケース
eBPF はすでに多くのプロダクトの土台になっている。
- 可観測性・監視: Pixie、Grafana Beyla(アプリを改修せずに HTTP などを計装する)、Parca(常時プロファイリング)。今回の eBPFLens もここに入る
- ネットワーク: Cilium(Kubernetes の CNI)、Meta の Katran(XDP を使った L4 ロードバランサー)、XDP による DDoS 対策
- セキュリティ: Falco、Tetragon。プロセスの起動やファイルアクセスを監視し、ポリシー違反を検知・遮断する
- 性能分析: BCC のツール群や bpftrace。runqlat や execsnoop は、もともと BCC のツールとして広まったもの
- スケジューラ: sched_ext(Linux 6.12 で取り込まれた)で、スケジューラ自体を BPF で書ける
eBPFLens の次の狙いは GPU 推論サーバーである。libcudart / libcuda に uprobe を掛け、推論プロセスごとに「カーネル起動・転送・同期待ち」を測れば、「GPU が遊んでいるのは CPU 待ちのせいか、転送待ちのせいか」を言えるはずだ。ちなみに、音源分離の Demucs(PyTorch の GPU 推論)を動かしながら runqlat を測ると、CPU の取り合いはほとんど起きていなかった(1 秒ごとの p99 の中央値は平常時 29 µs に対して 27 µs)。計算の大半は GPU で進み、CPU 側のスレッドは完了を待って寝ているからだ。
eBPFのメリット・デメリット
メリット
- 再起動も再ビルドも要らない。 動いている本番カーネルに、後から計測を足して外せる
- 安全。 verifier を通らないプログラムは入れられない。カーネルモジュールと違い、書き損じてもカーネルは落ちない
- カーネルの中で集計できる。 大量のイベントを 1 件ずつ外に出さず、要約だけを読める
- 取得間隔に縛られない。 ポーリングの隙間で起きて消えたもの(寿命 880 µs のプロセス)も拾える
- アプリを改修しなくていい。 uprobe ならライブラリの関数呼び出しも外から測れる
- CO-RE なら配りやすい。 監視対象に要るのはカーネルの BTF だけ。エージェントは単一バイナリになった
オーバーヘッドの小ささもよく挙げられるが、今回は計測していない。エージェントの常駐メモリが約 18 MB だった、というところまでである。
デメリット
- 強い権限が要る。 root か
CAP_BPFなどのケーパビリティが必要で、カーネル内のあらゆる情報に触れられる。取る情報の選び方には責任が伴う。eBPFLens では、プロセスのコマンドライン引数をあえて取らないことにした。mysql -pPASSWORDのように、引数に秘密が入ることがあるからだ - カーネルのバージョンに依存する。 CO-RE は構造体のずれを吸収してくれるが、フック先の関数やtracepointの引数そのものが変わると追従が要る。今回も
sched_switchとsched_process_exitの引数は、書く前にカーネル 7.0 の BTF で確かめた - 書き方に制約が多い。 verifier に安全だと証明できる形でしか書けない。ループの上限、配列添字の範囲チェック、NULL チェックを常に意識する
- ツールチェーンの癖に当たる。 bpf2go が
looking up type event: not foundで止まったことがある。ring buffer でしか使っていない構造体は BTF に載らないことがあり、型を明示的に参照させて回避した
- Linux 専用。 ネットワーク機器や Windows は対象外である
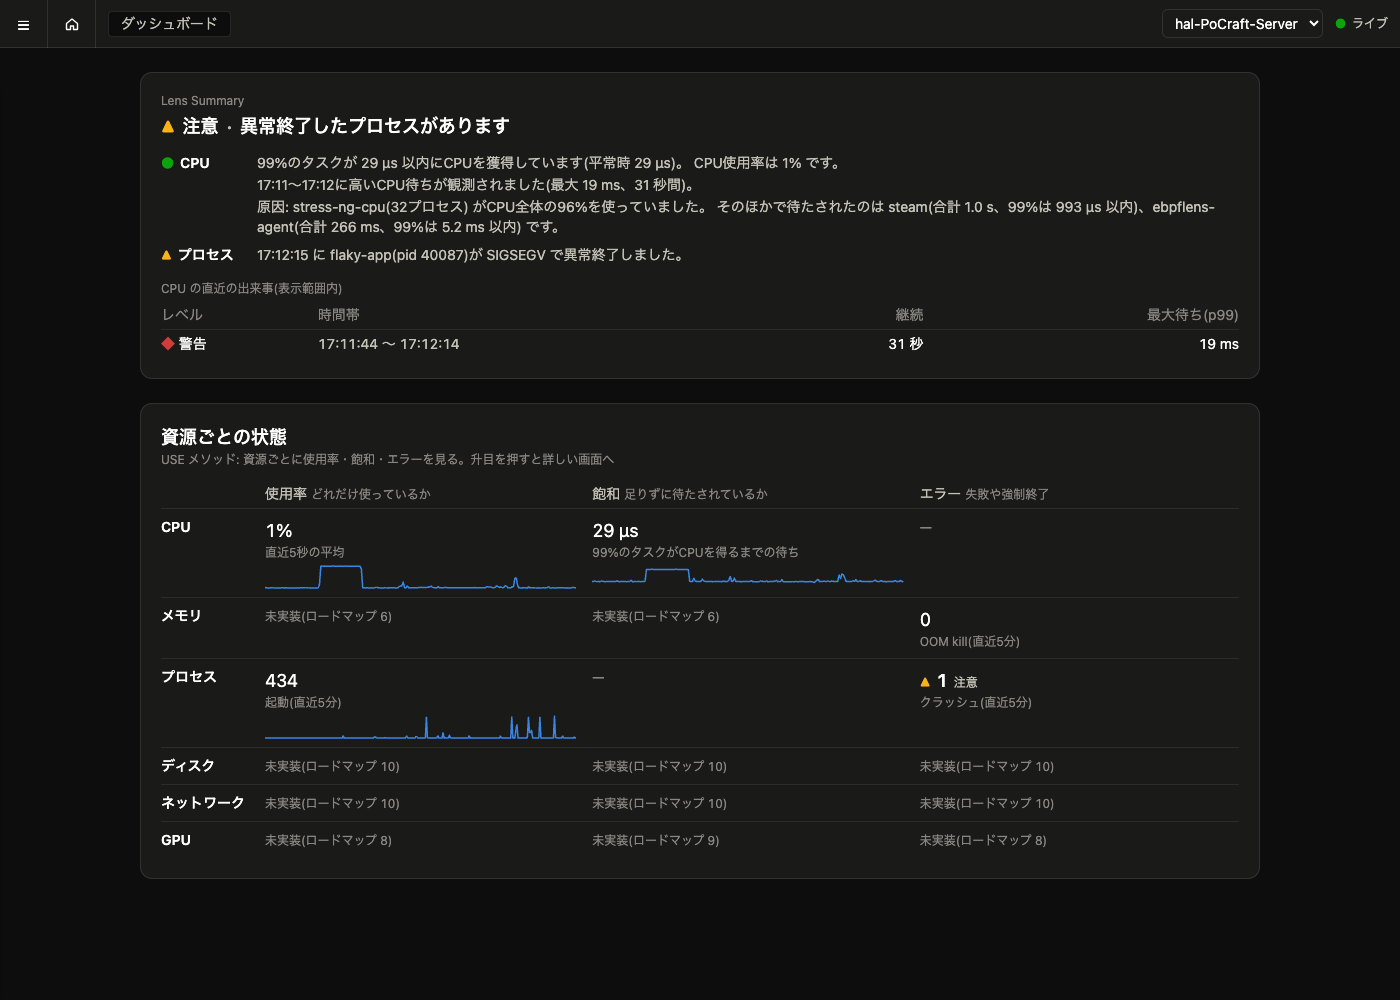
- 見えすぎる。 これが一番大きい。最初に作った画面は、ヒートマップと p50/p99 のグラフを並べただけで、「で、今は問題があるのか」が読み取れなかった。eBPF が出すのは生データであり、意味に変換するのは別の仕事である。eBPFLens では画面の一番上に、判定と文章の要約(「CPU待ち時間は低い状態です。99%のタスクが 29 µs 以内に CPU を獲得しています」)を置き、グラフはその根拠として後ろに回した
Zabbixとの比較
Zabbix と eBPF は、同じ「監視」でも立っている場所が違う。
| 観点 | Zabbix | eBPF(eBPFLens) |
|---|---|---|
| 取り方 | エージェントやサーバーが一定間隔で値を取りに行く(ポーリング) | カーネルのイベントにフックし、起きたそのときに処理する |
| 粒度 | 取得時点の値や、区間の平均 | 分布(ヒストグラム)、イベント 1 件ずつ |
| 間隔より短い現象 | 取りこぼす(寿命 1 秒未満のプロセスは基本的に見えない) | 拾える |
| 「なぜ」 | 「CPU 使用率が高い」「ロードアベレージが高い」まで | 「stress-ng が CPU の 99% を使い、victim-app が 1ms 待たされた」まで |
| 対象 | Linux、Windows、ネットワーク機器(SNMP)、アプリ、ログ | Linux カーネルと、その上のプロセス |
| 成熟度 | テンプレート、トリガー、通知、履歴の保存、権限管理がそろっている | プローブは作れるが、保存・通知・画面は自分で用意する |
| 導入の重さ | エージェントを入れてテンプレートを当てれば始められる | カーネルの知識と、権限の設計が要る |
比べてみると、置き換えではなく役割分担だと分かる。Zabbix は「広く・長く・漏れなく」見張って、何かおかしいことに気づくのが得意だ。eBPF は「その瞬間にカーネルの中で何が起きていたか」を掘って、なぜかを説明するのが得意だ。Zabbix のアラートで気づき、eBPF で原因を特定する。あるいは、eBPF で取った分布やイベントを Zabbix に流し込む。そういう組み合わせが現実的だろう。
eBPFLens では、この「気づく」側の画面も作ってみた。Brendan Gregg の USE メソッドに倣い、資源ごとに使用率(Utilization)・飽和(Saturation)・エラー(Errors)を升目に並べた。プローブが増えても升目が埋まっていくだけで、画面は縦に伸びない。
まとめ
- eBPF は、カーネルを変えずに、安全に、カーネルの中へ計測を差し込む仕組みである。verifier が安全を保証し、CO-RE が配布を楽にする
- できることは、カーネル内での集計、イベントの 1 件ずつの取得、プロセス単位への分解。ポーリングでは平均に埋もれる分布や、取得間隔の隙間で消えるプロセスが見える
- 代わりに、強い権限とカーネルへの依存を引き受けることになる。何を取らないかを決めるのも設計のうちだ
- Zabbix とは競合ではなく補完の関係にある。「気づく」のが Zabbix、「なぜを掘る」のが eBPF
- そして、生データを並べただけでは監視にならない。意味に変換して見せるところまでやって、はじめて道具になる
eBPFLens は GitHub で公開した(Apache-2.0): yoshiharu-ishii/ebpf-lens。この記事のあと、メモリ回収による停止(memstall)、SQLite への保存、systemd での常駐(エージェントは root をやめて CAP_BPF と CAP_PERFMON だけ)、英語化を足した。次は VM 監視(ホストから見た vCPU の待ちと、VM が落ちた理由)と GPU に進む。
コメント