YomiToku は Ollama で動いていると思っていた。違った。
前々回は「8GB の GPU で日本語の縦書き資料が 1 ページ 1 秒で読める」という結果を書いたが、OCR エンジンの中で何が起きているかは書かなかった。paperlake では OCR に YomiToku、エンジン比較と図の試験に Qwen3-VL(Ollama)を使っていて、どちらも「GPU で画像を読む日本語対応のモデル」なので、同じ仕組みで動いていると思い込んでいた。実際は正体も、動く場所も、画像の渡し方も違う。
| YomiToku(本番の OCR) | Qwen3-VL(ベンチと図の試験) | |
|---|---|---|
| 正体 | Python のライブラリ(PyTorch) | Ollama が配る視覚言語モデル(VLM) |
| 動く場所 | パイプラインのコンテナの中、同じプロセス | Ollama サービス(別プロセス、ポート 11434) |
| 画像の渡し方 | OpenCV で読んだ画素の配列を関数に渡す | base64 にして HTTP で POST |
| 中身 | 4 つの小さなモデルの分業 | 1 つの大きなモデル |
| VRAM | 約 2.6GB | 4B で 3.3GB、8B で 6GB 弱 |
| 使う場面 | すべての資料の OCR | エンジン比較と、図を Mermaid にする試験だけ |
今回はコードを一切出さずに、ページ画像が YomiToku に渡ってから Markdown が出てくるまでを順に追う。
画像はどう渡っているのか
表の 3 行目を言い換えると、YomiToku には画像を「送って」いない。paperlake のパイプラインと YomiToku は同じ Python プロセスの中にいて、OpenCV で読み込んだページ画像(高さ × 幅 × 色の画素の配列)をそのまま関数に手渡している。HTTP も base64 もない。GPU 上のメモリに配列を載せ、結果の構造(段落・図・表の一覧)がそのまま返ってくる。
対照的なのが、図の試験で使った Ollama 経由の VLM(Qwen3-VL)だ。あちらは Ollama がサーバーとして別プロセスで動いていて、画像を base64 の文字列にして JSON に埋め、HTTP で POST する。Ollama 側で復号し、視覚エンコーダが画像を数百〜数千の「画像トークン」に変換し、言語モデルがプロンプトと一緒に読んで文章を生成する。1 枚の図で入力トークンが 1,200 前後になったのは、そのほとんどが画像トークンだからだ。
この違いは設計上の違いであって、どちらが上という話ではない。ただ、paperlake が OCR にサーバー型の VLM ではなく組み込み型の YomiToku を選んだことで、GPU の使い方を自分で決められるようになった。後述するロックの話につながる。
YomiToku の中は 4 つのモデルの分業
YomiToku は 1 つの大きなモデルではなく、役割の違う 4 つのモデルを順に通す構成になっている。図にすると次のとおり。
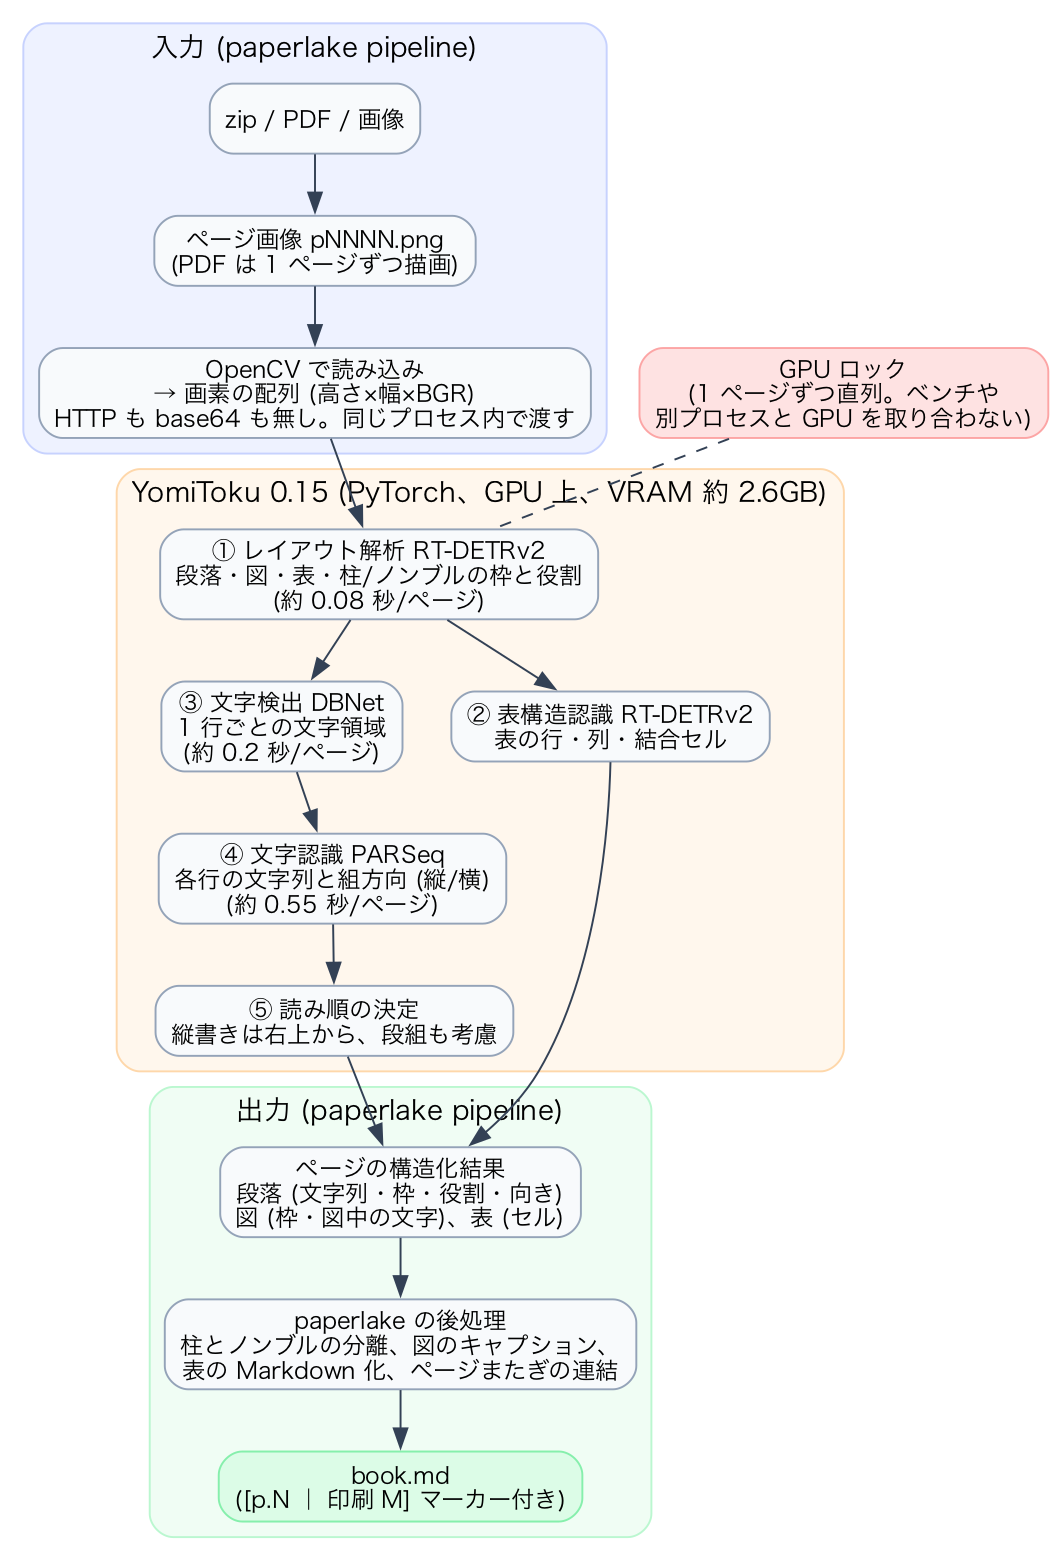
① レイアウト解析(RT-DETRv2)。 ページのどこに何があるかを枠で切り出す。段落、図、表、それに柱(ページ上部の章題)やノンブル(ページ番号)まで役割付きで返る。物体検出モデルの応用で、1 ページ 0.08 秒ほど。paperlake が図のキャプションと図中の文字を拾えるのも、表を Markdown の表にできるのも、この段階で「ここは図」「ここは表」と分かるからだ。
② 表構造認識(RT-DETRv2)。 ①で表と判定された領域だけ、行・列・結合セルの構造を読む。ここが取れると、セルの文字列を行列に並べ直して Markdown の表にできる。技術資料の 64 表がほぼ崩れず表になったのは、この段の精度による。
③ 文字検出(DBNet)。 段落の中の 1 行ずつの文字領域を見つける。縦書きなら縦長の帯、横書きなら横長の帯が並ぶ。1 ページ 0.2 秒ほど。
④ 文字認識(PARSeq)。 ③で切り出した各行の画像を文字列に変換する。ここが「OCR」と呼ばれる本体で、1 ページ 0.55 秒と最も重い。行ごとに組方向(縦か横か)も返り、paperlake は後でこれを「そのページは縦書きか横書きか」の判定に使う。ルビは別の行として検出されるので、YomiToku の設定で本文から除いている。
⑤ 読み順の決定。 ④まででページ上の文字列は揃うが、順番がない。縦書きなら右上から、段組があれば段ごとに、という規則で並べ替えて、初めて「本文」になる。スキャナ付属の OCR テキスト層を使わなかった理由の一つがここで、あちらは段落順が崩れることがあった。
4 つのモデルの重みは合計で数百 MB、GPU のメモリ(VRAM)は 2.6GB ほどで済む。8GB の GPU で動く理由はこの小ささにある。数 GB の VLM を 1 つ載せるのとは桁が違う。
そこから Markdown まで
YomiToku が返すのは「1 ページ分の段落・図・表の一覧」で、資料としてのまとまりはない。ここから先が paperlake の仕事になる。
- 柱とノンブルを本文から分ける。 役割が「柱」の枠から章題とページ番号を取り出す。横書きの技術資料では「2. 章題 21」のように 1 行に組まれているので、末尾の番号を切り出す。これができると、検索結果に「印刷 21 ページ」と出せるし、章題が変わったところに見出しを立てられる
- 図はキャプションと図中の文字だけ残す。 画像は残さない方針なので、図の枠に一番近い「図 N」で始まる段落をキャプションとみなし、図の中で読めた文字と一緒に本文の後ろに置く。図の意味は本文が説明していることが多く、それで十分だと分かった(前回)
- 表は Markdown の表にする。 ②の構造をそのまま行列にし、結合セルは左上に寄せる
- ページをまたいだ文をつなぐ。 ページ末が文の途中で終わり、次ページの先頭が続きなら 1 段落にする。段落の切れ目は字下げの全角スペースで判定する
- ページごとにマーカーを打つ。
[p.12 | 印刷 10]のように「入力の何枚目か」と「印刷されたページ番号」を併記する。検索で当たったチャンクから、原本のどこかに戻れるようにするためだ
この後処理はすべて文字列の操作で、GPU は使わない。OCR に 1 秒かかるページも、後処理は 1 冊分まとめて数秒で終わる。だから「Markdown の組み立て規則だけ変えたい」ときは OCR をやり直さず、保存しておいたページごとの結果から組み立て直せる(画面の「再構成」ボタン)。
GPU を 1 枚で回すためのロック
YomiToku が組み込み型であることの効用がここに出る。8GB の GPU に OCR モデル(2.6GB)と VLM(6GB 弱)を同時に載せると溢れる。図の試験でこれを踏んで、VLM の 7 割が CPU に退避して事実上止まった。
paperlake は「GPU を使う処理は一度に 1 つ」を、ファイルロックで守っている。パイプラインが 1 ページ処理するたびにロックを取り、ベンチのような別プロセスも同じロックを取る。だから OCR の途中でベンチを走らせても、GPU の上で重ならずに順番待ちになる。画面には「処理待ち(別の作業が使用中)」と出る。サーバー型の VLM に OCR を任せていたら、この制御はサーバー側の設定に縛られていた。
まとめ
- YomiToku には画像を「送って」いない。同じプロセス内で画素の配列を手渡す。Ollama 型の VLM は base64 で HTTP 越しに送り、画像トークンに変換される
- YomiToku の中はレイアウト解析・表構造認識・文字検出・文字認識の 4 モデルの分業で、最後に読み順を決める。合計 VRAM 2.6GB
- 文字にした後の「資料にする」部分(柱の分離、図・表、ページまたぎ、マーカー)は paperlake の後処理で、GPU を使わず、OCR をやり直さずに組み立て直せる
- 組み込み型だから GPU の使い方を自分で決められ、1 枚の GPU をロックで直列に使える
次は、この構造(章題が取れるようになったこと)を検索の単位に活かせるかを、精度の物差しで測る予定だ。
コメント