訂正(2026-10-01 夜、2026-10-02 に再訂正): この記事の結論「割り込みプローブ + ロックのプローブ + NVIDIA の割り込みの三つ巴」は間違っていた。同じ日の夕方に 4 回目が起き、kdump で全 CPU のバックトレースが取れた。スタックに NVIDIA も割り込みプローブも居らず、原因はロックのプローブ同士の入れ子と、カーネルの rqspinlock のバグの重なりだった。検証機ではロックのプローブが 2 本(常駐と検証用)載っていた。
jiffies_lockの競合で鳴ったlock:contention_endの BPF が LRU ハッシュマップからエントリを消そうとし、そのマップの bucket ロック(BPF の rqspinlock)が競合して自分自身のcontention_endを鳴らし、もう 1 本の BPF が入れ子で走って自分のマップの bucket ロックを取りに行った。rqspinlock はデッドロックを検出したが、抜ける途中の待ちで止まった(カーネルのバグで、上流の 7a3c0289c3c8 で修正済み)。jiffies_lockを握ったまま止まるので全 CPU が巻き込まれる。割り込みプローブと GPU は確率を上げる触媒にすぎなかった。下の「三つ巴の中身」「誰でも踏む」の因果の説明は誤りで、症状・消去法の表・直し方(割り込み文脈でロックを取らない)は事実のまま残している。直しは結果的に正しい穴を塞いでいた。最初の訂正では「ロックのプローブ単体の再帰で、同じ bucket を取りに行った AA デッドロック」と書いたが、ダンプを読み直すと 2 本が別々のマップで入れ子になっていたので、そこも直した。読み解きはリポジトリの ADR 0004 にある。
eBPF で Zabbix 風のダッシュボードを再発明している eBPFLens の続き。前回までで CPU・メモリ・プロセス・VM・GPU・ディスク・ネットワーク・DNS を埋め、今回はロードマップの最後の 4 項目 — ファイル操作の失敗と fsync、ロック待ち、ページフォールトとスワップ、割り込み — を一日で足した。その途中で検証機が 3 回、ログを一行も残さずに固まった。この記事はその原因究明の記録で、結論から言うとカーネルのルール上は全部許されている操作の組み合わせが hard lockup を起こした。同じ組み合わせは、eBPF で監視を書く人なら誰でも踏みうる。
足したもの(手短に)
4 つのプローブはそれぞれ短い謎解きがあったが、本題ではないので要点だけ。
ファイル。設定ミスの半分は open() の失敗として現れる。無い証明書、サービスのユーザーが読めない鍵、読み取り専用になったマウント。これを open / openat / openat2 の syscall tracepoint で拾う。最初は do_sys_openat2 の fexit で取ろうとしたが、最近のカーネルではインライン化されていて legacy の open() 経路しか鳴らない。do_filp_open に至っては kallsyms に無い。結局、生の syscall tracepoint が一番確実だった。fsync の待ちは do_fsync の fentry/fexit で、ファイル名は fd の先の dentry から親ディレクトリ名と一緒に読む。vfs_fsync_range の方が io_uring も拾えて筋がいいのに、これもインライン化されていて一度も鳴らなかった。副産物として、eBPFLens 自身の SQLite の WAL の fsync が SATA SSD の writeback の後ろで 260 ms 待っているのが見つかった。
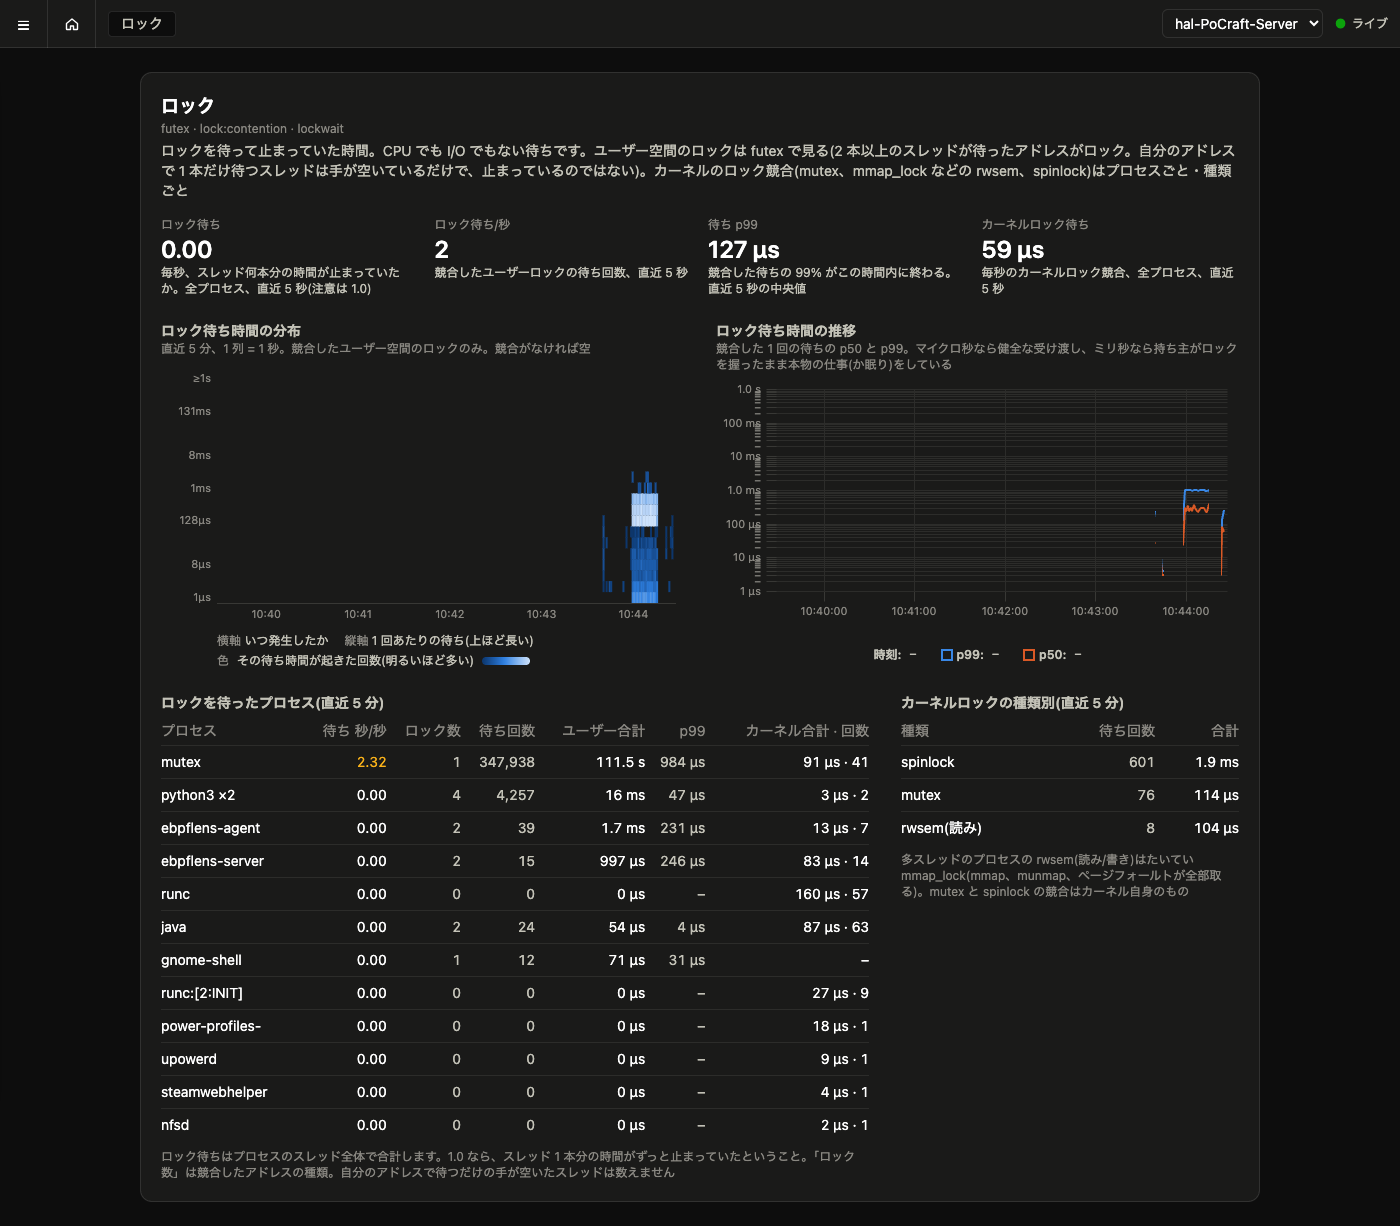
ロック。「CPU でも I/O でもない待ち」を測る。ユーザー空間のロックは futex システムコールに降りてくるが、手の空いたスレッドを寝かせる(Go のスケジューラ、スレッドプール)のも同じ futex で、それは競合ではない。見分け方はアドレスだった。競合したロックは 2 本以上のスレッドが同じアドレスで待ち、寝ているスレッドは自分専用のアドレスで 1 本だけ待つ。実測で、8 スレッドが 1 つの mutex を取り合うと 1 アドレスに 70 秒、手の空いた Go サービス群は 13 アドレスに 80 秒だが全部 1 本待ち。この規則でゼロと数えられる。
glibc の遅い経路 __lll_lock_wait に uprobe を打つ案は、そのシンボルが動的シンボル表に無くて(bpftrace は debuginfod 経由で見つけていた)捨てた。
ページフォールト。handle_mm_fault の fentry/fexit で全フォールトを計時し、major(ページがディスクから来た)をプロセスごとに、ファイルの無い VMA の major = スワップインを分けて数える。メモリ画面の 2 節目になった。
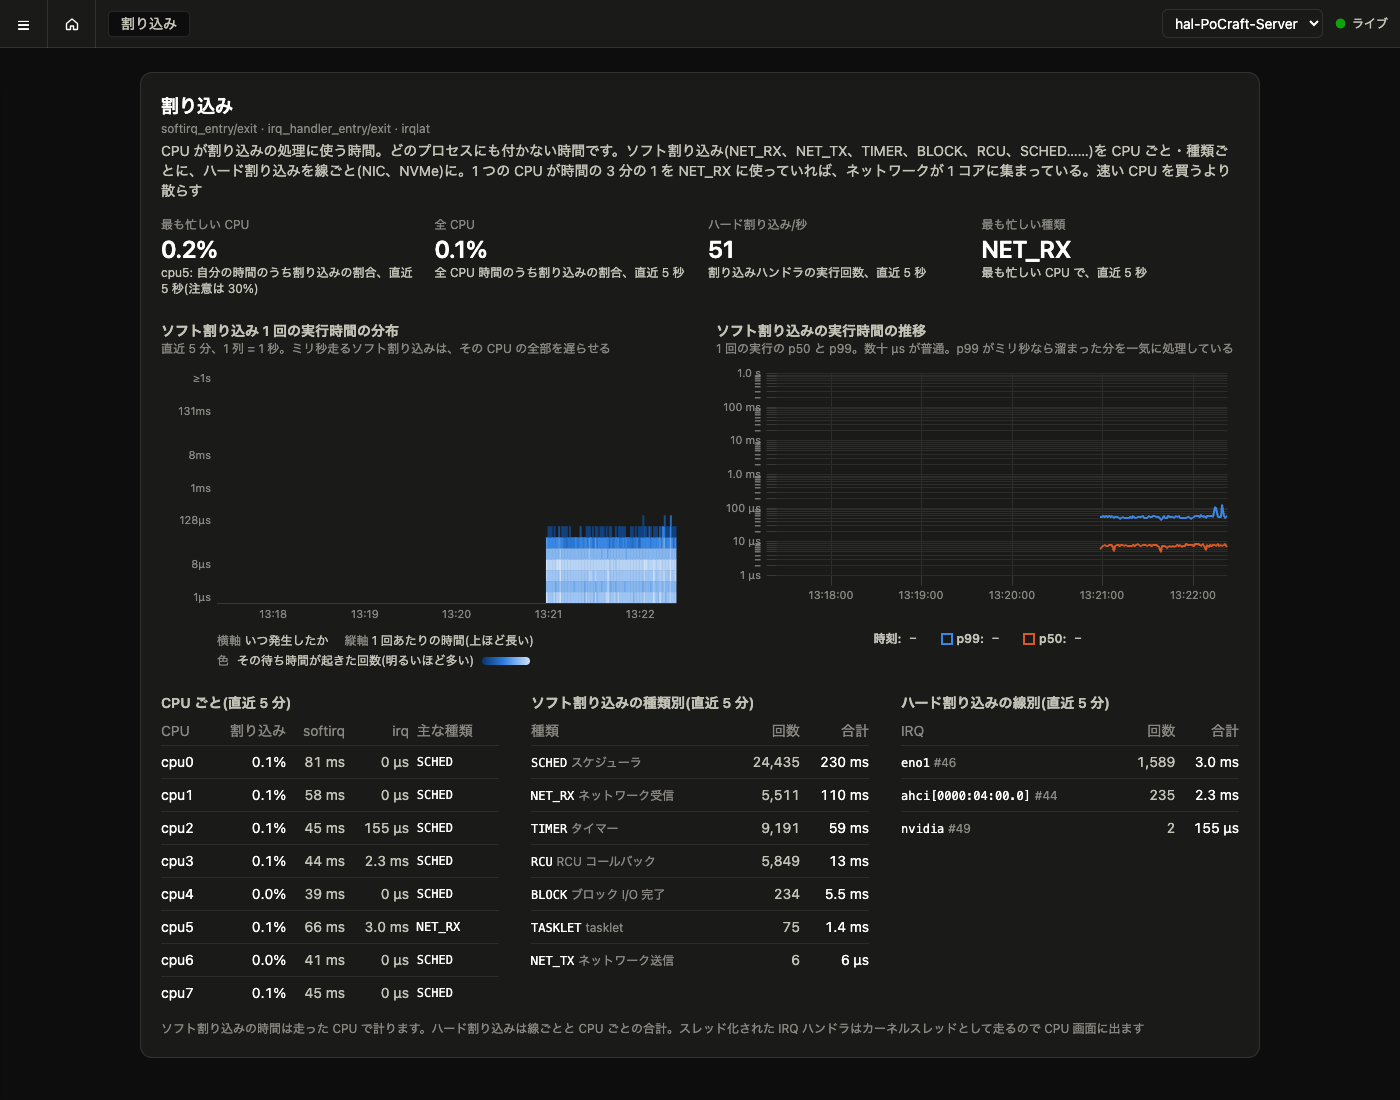
割り込み。top が誰にも付けない時間。softirq を CPU × 種類で、hardirq を線ごとに測る。NIC が全パケットを 1 コアに届けていると、そのコアが謎に忙しくなる、あれだ。これが今回の主役になる。
症状: 負荷が終わって 1〜2 分後に、黙って止まる
4 つ目の割り込みプローブを入れた全部入りのエージェントで、いつもの検証をした。ページフォールトを起こすスクリプトを 3 本、loopback に 64 KB を送り続けるスクリプトを cpu3 に固定して 2 本、18 秒。負荷は正常に終わり、ダッシュボードにも出来事が出た。
その 1〜2 分後、ping が返らなくなった。ssh も駄目、Wake-on-LAN も効かない(電源が落ちたのではなく、固まっている)。電源を入れ直してもらい、前回ブートの journal を見ると、最後の行は負荷スクリプトのセッションが閉じた記録で、その後は何もない。Oops も soft lockup も MCE もなし、pstore も空、温度は 51°C。NMI watchdog は有効だったのに何も出なかった。これは全 CPU が止まる hard lockup か、それに近いものだ。
唯一の手がかりは、負荷の最中に 1 行だけ出ていたこれ。
clocksource: Long readout interval, skipping watchdog check: cs_nsec: 1074751507 wd_nsec: 1074751265
ある CPU で 1.07 秒、タイマーが動かなかった。カーネルの中で何かが 1 秒スピンしている。
消去法
ログが無い以上、消去法しかない。1 回の試行ごとに固まる可能性があり、固まれば電源を入れ直してもらう。試行は「負荷 18 秒 → 放置 4 分、dmesg を見張る」で揃えた。
| 構成 | 結果 |
|---|---|
| pgfault 単独(probe-only) | 生存 |
| irqlat 単独(probe-only) | 生存 |
| 全部 − irqlat | 生存(ただし 1 秒停止の警告が 1 回) |
| 全部 − pgfault(irqlat あり) | 凍結 |
| irqlat + GPU(lockwait なし) | 生存 |
| irqlat + lockwait(GPU なし)、hal でも VM でも | 生存 |
| irqlat + GPU + lockwait | 凍結(再現) |
3 つ揃うと死ぬ。どれか 1 つ欠けると生きる。プローブを 1 つずつ外せるように、エージェントに -disable フラグを、1 つだけ動かす probe-only という小さなコマンドを、調査の途中で足した。
VM の実験は「カーネルのバグなら VM でも再現するはず」という発想で挟んだ。libvirt の lab VM は hal とほぼ同じ 7.0 系カーネルで、GPU だけが無い。loopback の送信は softirq しか鳴らさないので、ホストから VM へ TCP を叩き込んで virtio-net の本物の hardirq を毎秒 500 ms 分浴びせた。それでも生きた。第 3 の要素は NVIDIA の割り込みそのものだと分かった。
三つ巴の中身
この節の因果の説明は誤り(冒頭の訂正を参照)。実際のスタックに居たのは 3 の lockwait だけで、1 と 4 は確率を上げる触媒だった。記録として本文はそのまま残す。
3 つのプローブが何をしているかを並べると、連鎖が見える。
- irqlat は
irq_handler_exitとsoftirq_exitの tracepoint に付いていて、hardirq / softirq の文脈でハッシュマップを更新する。ハッシュマップの bucket はスピンロックで守られている - そのスピンロックが競合すると、カーネルは
lock:contention_beginを鳴らす - lockwait はまさにその
lock:contention_begin/endに付いている。つまり irqlat のマップのロック競合が、割り込みハンドラの文脈の中で lockwait の BPF を走らせる。lockwait はそこで自分の LRU とハッシュ(どちらもロック付き)を更新する - GPU プローブは毎秒 NVML でドライバに問い合わせるので、NVIDIA の割り込みハンドラが活発になる。プロプライエタリで中身の見えない、長い ISR がこの連鎖の隣で走る
どれもルール上は許されている。BPF は同じプログラムの再入を防ぐし、ハッシュマップは同じ CPU で同じマップの bucket を取り直そうとすれば -EBUSY を返す。検証器はこのプログラムを通す。それでも揃うと止まる。カーネルのどこで何が起きているかは、最後まで証拠を取れなかった(後述)。
直し方: 解明するのではなく、問いを立てない
原因の最後の一片が NVIDIA ドライバの中なら、追い切れない。代わりに、連鎖の最初の輪を断つ。
割り込み文脈で走る BPF は、ロックを取るマップを触らない。
- irqlat はハッシュマップをやめて per-CPU 配列だけにした。softirq は「種類 × CPU」、hardirq は「IRQ 番号 × CPU」。割り込み文脈でやることは、自分の CPU の配列に足し算するだけ。IRQ 名はカーネルの中で
action->nameを読むのをやめ、ユーザー空間で/proc/interruptsから取る - lockwait は、割り込み文脈で起こりうる唯一の競合である spinlock の待ちを per-CPU の枠に記録し、種類別にだけ数える(mutex と rwsem は眠るロックなのでプロセス文脈。従来通りスレッドごとの LRU でプロセスに付ける)
直したあと、固まっていた構成で 4 分、全部入りで 5 分。カーネルの警告はゼロ。
解明の試み、そして再現しなくなった
直したからといって「なぜ」が分かったわけではないので、もう一段追った。hard lockup を panic にして 15 秒で自動再起動する sysctl を入れ(電源ボタンが要らなくなる)、panic のログが EFI pstore に残るようにし、修正前の irqlat と lockwait を main に当てた再現ビルドを作った。netconsole も試みたが、Mac と検証機の間で UDP が双方向とも通らず(TCP と ICMP は通る)、諦めた。
結果: 同じ負荷を 3 回、各 9 分。1 本、2 本、E2E 構成。全部生き残り、前兆の clocksource の警告すら出なかった。
午前中は 3/3 で死んだのに、午後は 0/3。はっきり違うのは、常駐の本番エージェントが修正後になっていたことだ。午前は本番も修正前の lockwait で、contention tracepoint にロック付きマップを触る BPF が常駐していた。再現ビルドを 2 本立てて本数は揃えたが、同じ状態にはならなかった。再現性に運の要素もあるのだろう。これ以上やるなら kdump で vmcore を取って crash で読むしかなく、それには本番を修正前に戻して罠を仕掛けたまま放置する必要がある。今回はここで止めた。
誰でも踏む
この組み合わせは特殊ではない。
lock:contention_begin/endに BPF を付けるのは普通のことだ。perf lock contention自体がこの tracepoint で動いている- hardirq / softirq の tracepoint にハッシュマップ付きの BPF を付けるのも普通のことだ。bcc の
hardirqs/softirqsがそのまま、それだ - その横に長い ISR を持つドライバがいる。GPU サーバーでロックの監視と割り込みの監視を両方入れたら、それだけで揃う
そして検証器は通り、ログは残らない。「許されている」と「安全」は違う、を身をもって知る類の話だった。eBPFLens では規則として README とマニュアルに書き、調査に使った道具(-disable、probe-only)はリポジトリに残してある。検証機には「固まったら黙って死なず、panic して自動再起動し、痕跡を pstore に残す」設定を永続化した。次に起きたら、今度は喋る。
おまけ: 4 つのプローブが本物を見つけた話
調査の合間に、新しいプローブが検証機の本物を拾っていた。
localsearch-3(GNOME のファイルインデクサ)が 9 秒間、スレッド 7.4 本分の時間を自分のロックで止まっていた(lock_wait警告)- eBPFLens 自身の SQLite WAL の fsync が、バックアップ的な大きな書き込みの writeback の後ろで 260 ms 待っていた(
fsync_slow) eno1の割り込み毎秒 2,700 回が、全部 cpu3 に落ちている。今の量なら無害だが、通信が 10 倍になったときに問題になる形がそのまま見えている- Rust 版 coreutils の
catは開く前にstat()で確かめるので、権限エラーがopenには出ない。「open の失敗を見る」の限界として書いた
リポジトリ: y6ui3i/ebpf-lens。ロードマップは 14 項目すべて実装済みで、11 のプローブが検証機で動いている。
コメント