前回の記事で、eBPF で Zabbix 風のダッシュボードを再発明する eBPFLens を作り始めた話を書いた。CPU の実行待ち、プロセスの生死、メモリの回収停止、VM の「なぜ止まったか」までが前回。今回はロードマップの残り、GPU・ディスク・ネットワークを一日で埋め、ついでに UX を整えた。作業記録というより、途中で引っかかった謎解きを中心に書く。eBPF の話は最後にはたいてい「カーネルは何を知っていて、何を知らないか」に行き着く。
設計の縛り
eBPFLens には自分で決めた縛りがある。eBPF が主役で、/proc は答え合わせ。そしてもう一つ、ADR 0001「Everyone an SRE」— 画面の一番上には数字ではなく判定文を置き、根拠と次の一手を添える。グラフは証拠であって主役ではない。
この縛りが GPU で最初に破れる。カーネルは GPU が何をしているか知らない。稼働率も VRAM も温度も NVIDIA のドライバの中にしかなく、届く道は NVML(nvidia-smi と同じ源)だけだ。だから GPU の「デバイス側」だけは例外で NVML を使う、と ADR 0003 に書いた。
GPU: nvidia-smi が答えられない問い
nvidia-smi は「GPU は 30% 稼働」とは言う。でも「なぜ 30% なのか」は言えない。推論機を運用する人が知りたいのはそこだ。前処理が CPU で詰まっているのか、ホストと GPU の転送で詰まっているのか、それとも入力待ちで暇なだけなのか。
答えはプロセス側にある。CUDA を使うプログラム — PyTorch でも llama.cpp でも自作でも — は最後には libcuda.so.1 のドライバ API を通る。そこに uprobe を刺す。
cuLaunchKernel/cuGraphLaunch: GPU に仕事を渡した回数cuMemcpyHtoDAsync/DtoHAsync: 転送バイト数と、呼び出しの中で止まっていた時間cuStreamSynchronize/cuCtxSynchronize/cuEventSynchronize: GPU を待っていた時間
これをプロセスごと・秒ごとに集め、runqlat から取っているそのプロセスの CPU 時間と突き合わせる。すると「GPU が 5% 稼働で、プロセスは 1 コアの 95% を使っている」という組み合わせが見える。判定はこうなる。
| 判定 | 条件 |
|---|---|
| GPU が上限 | GPU 稼働 80% 以上。プロセスは GPU を待っていて、それが正常 |
| 転送が上限 | 時間の 30% 以上が転送呼び出しの中 |
| GPU と CPU | GPU は時間の一部だけ働き、残りはプロセスが CPU で計算 |
| CPU が上限 | GPU は遊んでいて、プロセスは 1 コアの 50% 以上 |
| 別の待ち | CPU でも CUDA 呼び出しの中でもない。I/O、ロック、入力 |
| 何もしていない | モデルを載せたまま要求なし |
謎解き 1: 転送は synchronize では止まらない
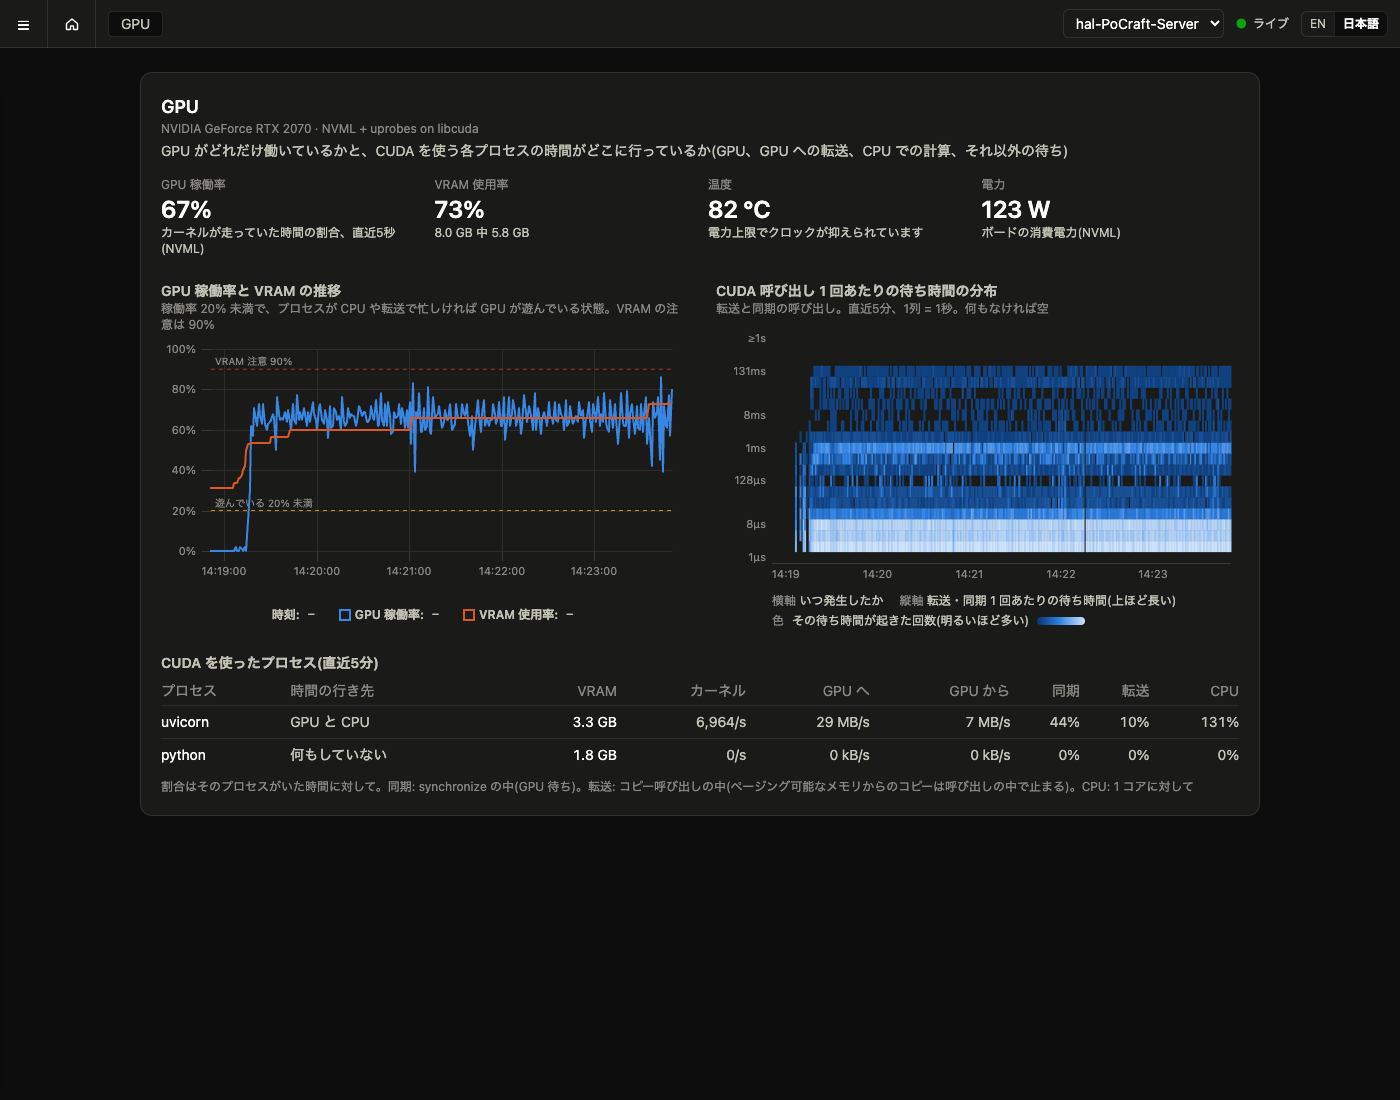
最初のスパイクは PyTorch で 4096² の行列積と、毎回 256 MB をホストから GPU へコピーするループ。uprobe の集計は launch 41 回、H2D 10.7 GB(40 × 256 MB でぴったり)、synchronize 40 回。ところが synchronize 1 回の時間は 64〜128 µs しかない。256 MB の転送は 25 ms はかかるはずなのに、どこに消えた?
答えはページング可能なホストメモリからのコピーは cuMemcpyHtoDAsync の呼び出しの中で止まる、だった。Async という名前に反して、pinned でないメモリからの転送はドライバがステージングバッファへ CPU でコピーする間ブロックする。だから転送呼び出しの時間も計らないと「転送が上限」は見えない。実測では 982 ms/秒がコピー呼び出しの中、GPU の稼働率は 30〜78%。判定は「転送が上限」、次の一手は pinned メモリ。
謎解き 2: CAP_PERFMON があるのに uprobe が刺せない
エージェントは root ではなく、CAP_BPF と CAP_PERFMON だけの専用ユーザーで動かしている。tracepoint も fentry も問題なかったのに、uprobe だけ permission denied。
原因は Ubuntu のカーネルが kernel.perf_event_paranoid=4 で、この値では CAP_SYS_ADMIN が無い限り perf_event_open を拒否する(CAP_PERFMON では足りない)。古典的な uprobe は perf_event 経由で付ける。
逃げ道は multi-uprobe の BPF リンク(カーネル 6.6 以降)。SEC("uprobe.multi") で書いた BPF プログラムを bpf_link_create で付けるので perf_event_open を通らず、CAP_PERFMON で足りる。cilium/ebpf なら Executable.UprobeMulti。シンボルの有無は debug/elf で先に調べて、そのドライバ版が持っているものだけを渡す。
謎解き 3: GeForce はプロセス別稼働率をくれない
NVML には nvmlDeviceGetProcessUtilization があるが、GeForce では Not Found が返る。最初は困ったが、考えてみるとこれは設計の追認だった。「どのプロセスが GPU を何%使ったか」ではなく「そのプロセスが GPU 以外で何をしていたか」を uprobe で取るのが、そもそもの狙いだったのだから。
ベンチで本物を拾う
ちょうど自炊した本を取り込みたかったので、OCR パイプライン(YomiToku、コンテナ内)に 1200 dpi の本を 2 冊流し、ダッシュボードで眺めた。コンテナ内のプロセスも見える。NVIDIA container toolkit がホストの libcuda.so.1 をそのまま bind mount するので、同じ inode に uprobe が効く。
OCR 中は「GPU と CPU」。GPU 64%、カーネル起動 5 千回/秒、CPU は 1 コアの 112%。次に効くのは CPU 側。
そして OCR の前、PDF を 1200 dpi の JPEG にする段階で gpu_starved の警告が開いた。「GPU は 0% 稼働、プロセスは時間の 97% を CPU で計算」と uvicorn を名指しして 42 秒、OCR が始まると閉じた。nvidia-smi なら「0%」としか出ない場面で、これがこの機能の存在理由だ。
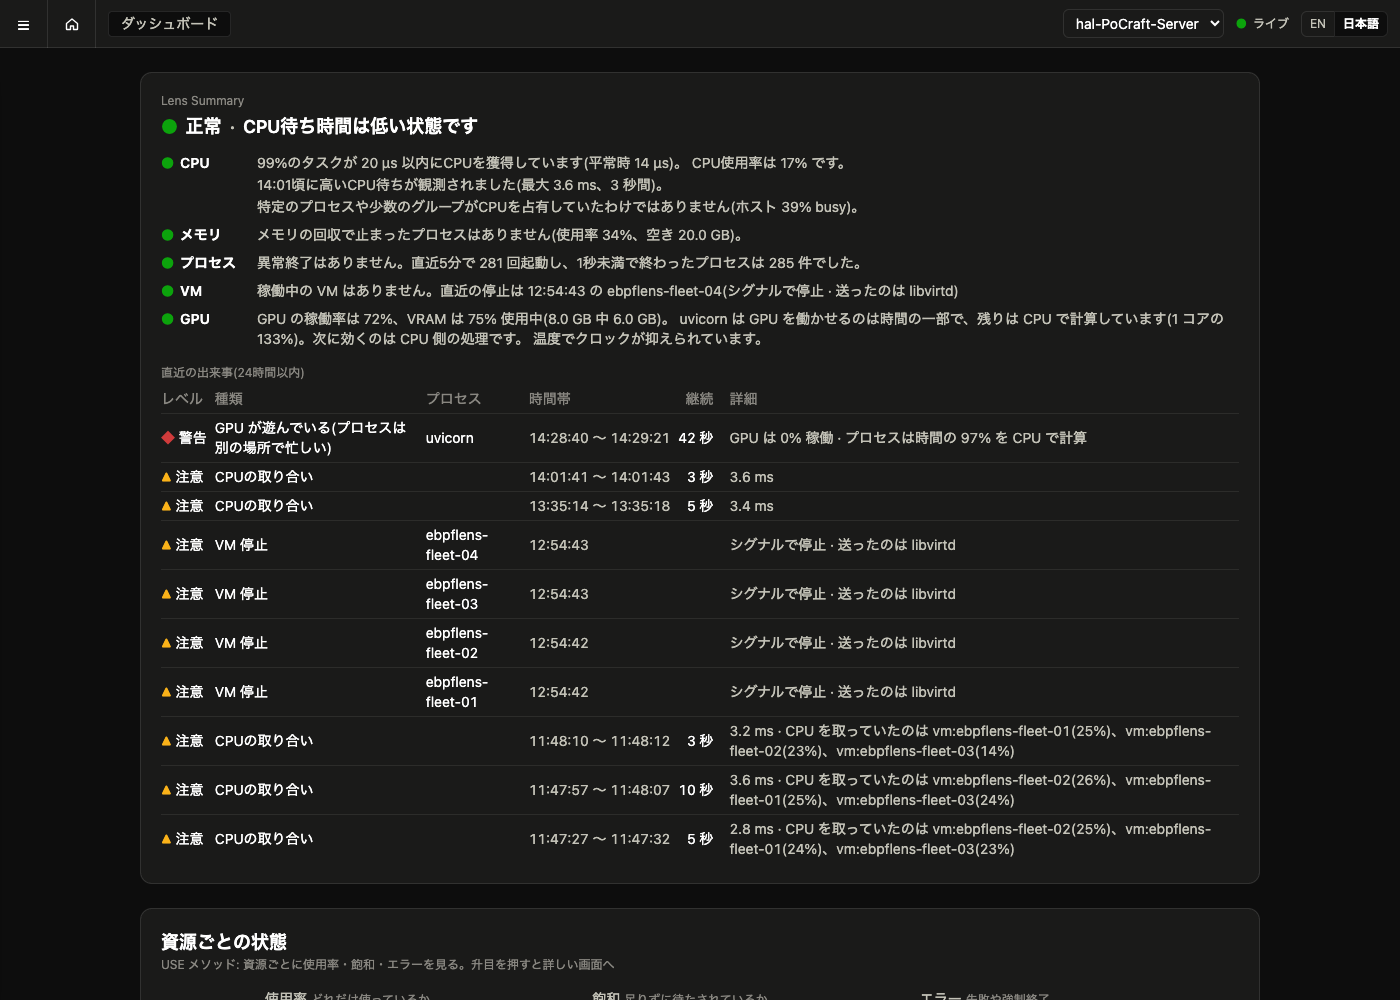
ついでに RTX 2070 が 83℃ で温度によるクロック抑制に入っていることも分かった。温度のタイルがそう言う。
ディスク: 誰が I/O を出したのか
ディスクは biolatency の考え方。block_rq_issue から block_rq_complete までを I/O 1 件ずつ計り、ディスクごと、出したプロセスごとに集める。
謎解き 4: block_rq_issue の comm は嘘をつく
最初は block_rq_issue の時点の current をプロセスとして記録した。dd で書き込むと、出し手の表に kworker/1:1H、kworker/3:1H が並ぶ。dd はどこへ行った?
bpftrace で確かめると、dd は block_bio_queue で 1689 個の bio を出しているのに、block_rq_issue は一部が kblockd(kworker/N:1H)の文脈で走っていた。ディスパッチはワーカーがやることがある。だから出し手は block_bio_queue(出し手の文脈)で覚えて、block_rq_issue でリクエストの先頭 bio から引く。
これで直ると思ったら、今度は kworker/u32:4 が 69% を占めた。bpftrace で bio の持ち主と issue の comm を並べると、持ち主が本当に kworker/u32 の bio があった。理由が 2 つ。
- 大きな bio は split される。分割後の先頭 bio は新しいポインタで、
block_bio_queueを通らない - 別リクエストに merge された bio は一度も参照されず、map に残る。bio の構造体はスラブで再利用されるので、同じアドレスに来た次の bio が古い持ち主を引き継ぐ
block_split でも記録し、block_bio_complete で消し、map を LRU にして解決した。1.5 GB の dd で dd 100% になった。残った kworker/u32 は本物のページキャッシュ writeback で、それはそれで正しい出し手だ。
BPF のスタックと検証器
小さな事故も 2 つ。27 スロットのヒストグラムを持つゼロ初期化の構造体を 2 つスタックに置いたら 512 バイトの上限を超えた(.rodata の static const に逃がす)。もう一つは検証器が map の呼び出しをまたぐと slot の範囲を忘れるので、使う直前に barrier_var(slot) と再チェックを置く。memstall のときに一度踏んだ穴を、また踏んだ。
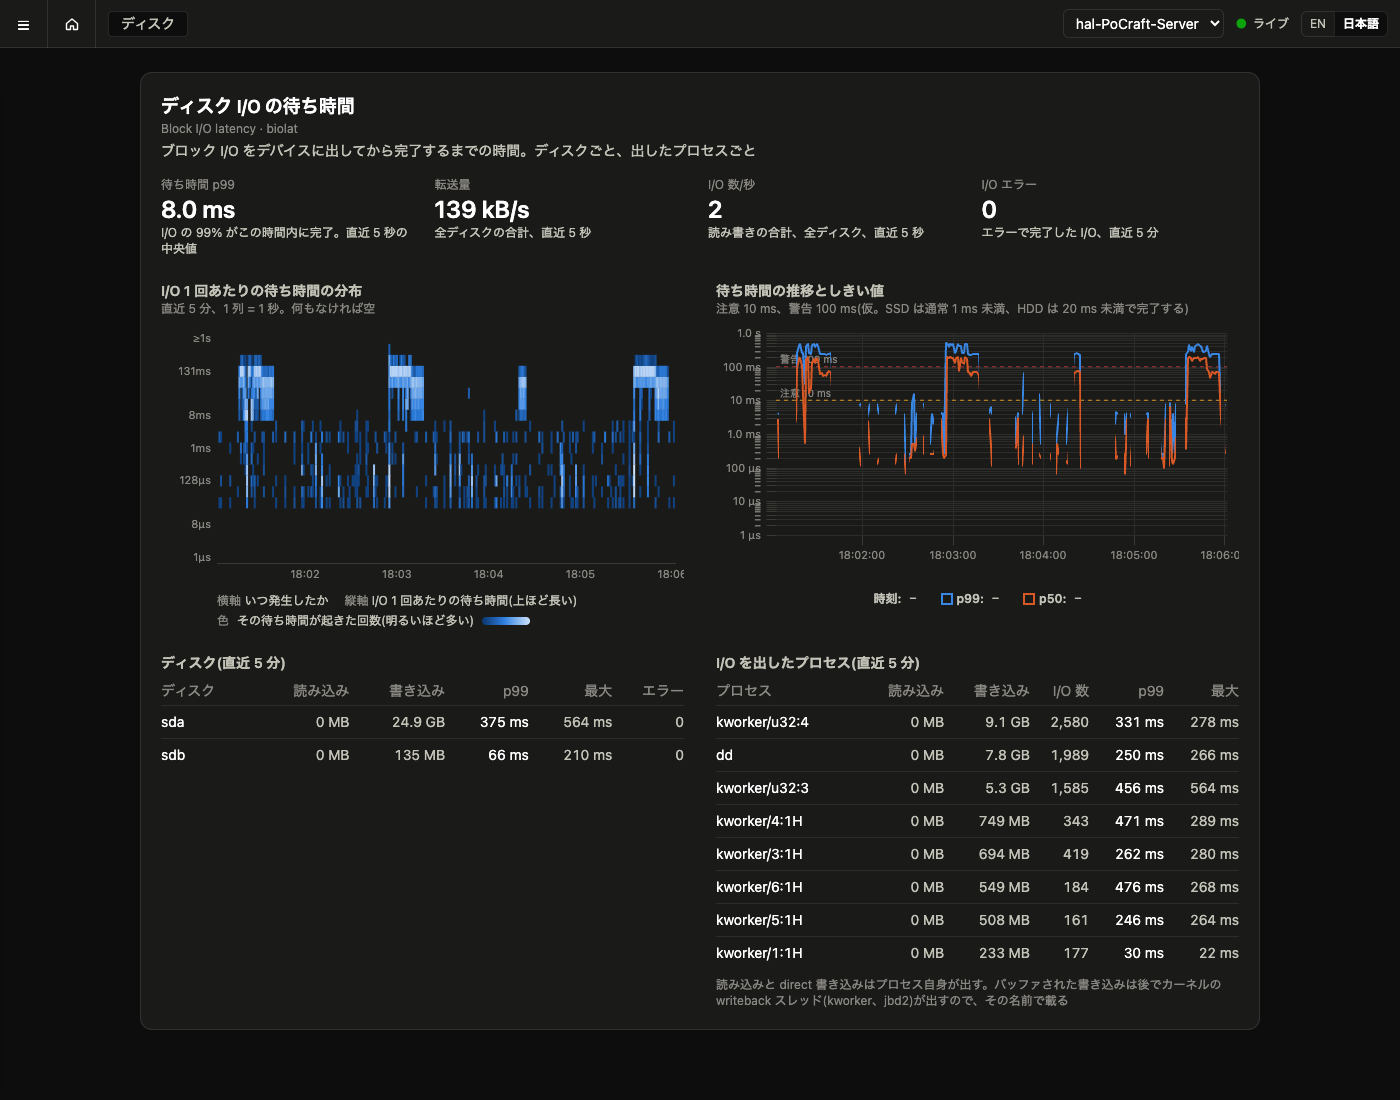
検証機の SATA SSD は dd oflag=direct 360 MB/s で 4 MB のリクエストになり、p99 が 250〜510 ms まで伸びた。壊れているのではなく、忙しいデバイスの深いキューがそう見える。しきい値(10 ms 注意 / 100 ms 警告)は仮で、ホストごとに合わせるものだと README に正直に書いた。
ネットワーク: 1 秒は「遠い」ではなく「落ちている」
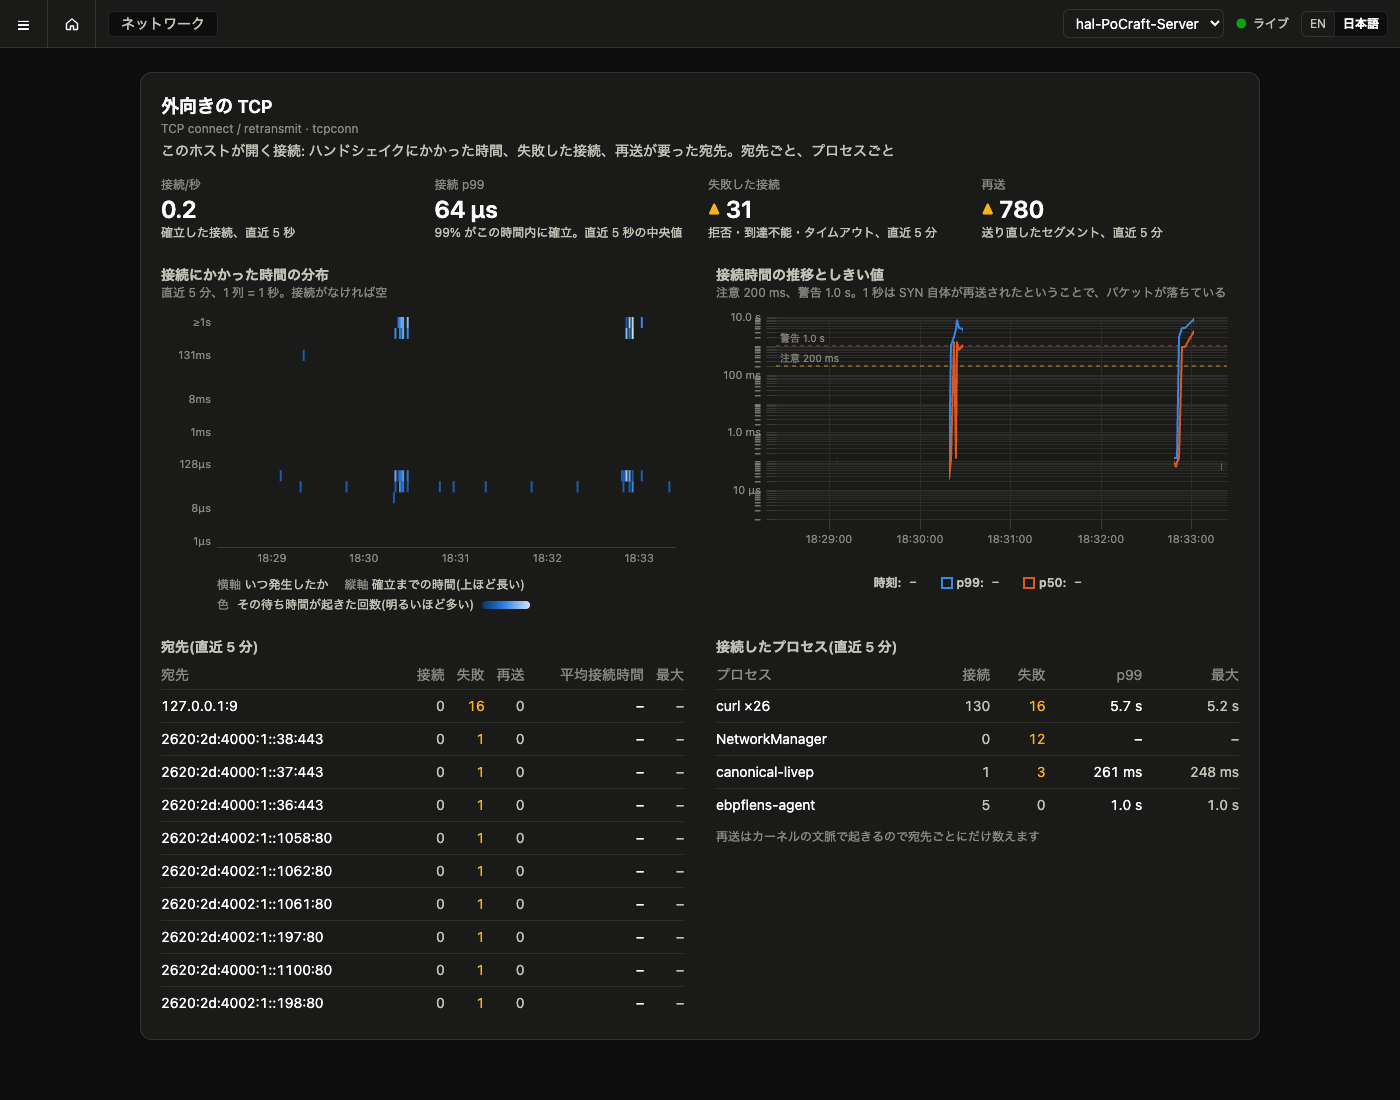
ネットワークは tcpconnect / tcpconnlat / tcpretrans を 1 つのプローブにまとめた。inet_sock_set_state で SYN_SENT → ESTABLISHED の時間(接続の遅延)と SYN_SENT → CLOSE(失敗)を、tcp_retransmit_skb で再送を、宛先 addr:port ごとに数える。connect() は呼んだプロセスの文脈で SYN_SENT に入るので「誰が」も取れる。
検証は tc qdisc add dev lo root netem loss 40% で自分のサーバーに curl を 40 本。接続にかかった時間が 1.0 秒、2.0 秒、8 秒と、SYN の再送スケジュールそのものになった。だから net_connect_slow の警告は 1 秒に置いた。接続に 1 秒かかったなら SYN 自体が落ちている。それは遠い宛先ではなく、パケットが落ちる経路だ。
謎解き 5: 拒否の連発は rate では拾えない
閉じたポートへ 6 回 connect すると、6 回とも 1 秒以内に失敗する。「失敗 1 回/秒以上が 3 秒続く」というルールは、1 秒で終わるバーストを一度も拾えない。ほかのルールと同じ「値がしきい値を超えたまま N 秒」の型が合わない例で、net_connect_fail だけは 10 秒の窓の件数にした。
初回から本物
ページを開いた瞬間に、宛先の表に 2620:2d:4000:1::38:443 が失敗 1 と並んでいた。canonical-livepatch と NetworkManager が IPv6 で接続しては失敗している。検証機に IPv6 の経路が無いのに、5 分ごとの接続性チェックが v6 を先に試すからだ。害はないが、netstat -s ではホスト全体の 1 つの数字にしかならない。
これは別の穴も見せてくれた。12 件の失敗が 12 個の別々の宛先に 1 件ずつなので、「10% 以上の宛先をグループにする」ルールでは誰も名指しできない。宛先単位で誰も目立たないときは IPv4 はアドレス、IPv6 は /64 でまとめ直すようにして、「2620:2d:4000:1::/64 (67%)」と言えるようになった。
UX: 死んだ VM をどうするか、設定をどこに置くか
機能が揃ったので、使い勝手に手を入れた。
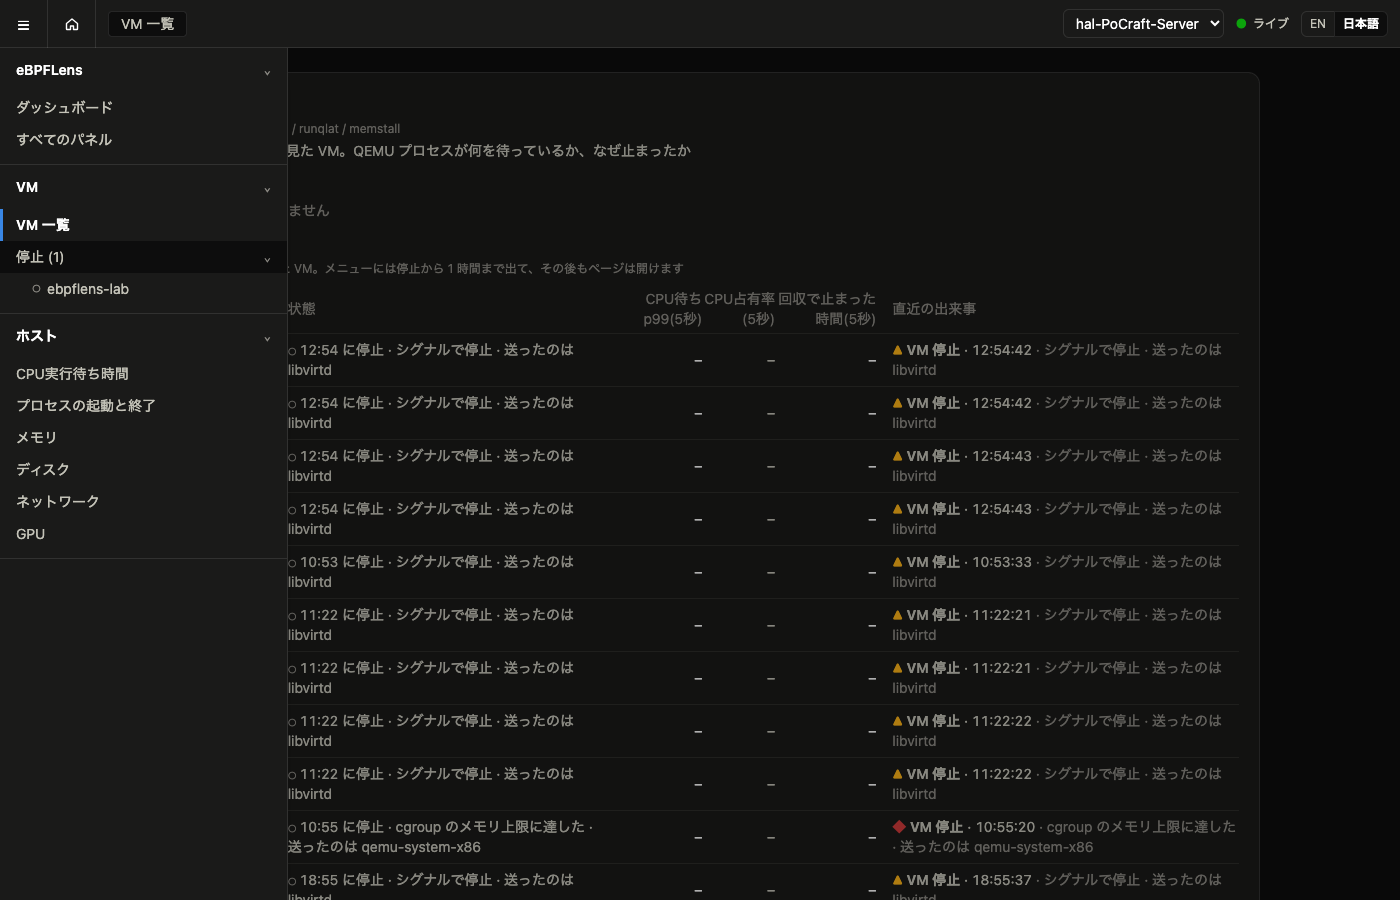
VM の寿命。 10 台の VM をまとめて消したあと、メニューに 10 台の「停止」が居座っていた。ホストからは「停止した」と「消された」を区別できない(libvirt の定義は root 専用で、Proxmox はまた別)ので、時間で決める。停止から 5 分はレベルの印付きでメニューに、1 時間は「停止 (N)」の折り畳みに、24 時間は一覧にだけ、その後は消える。ページは DB が出来事を 30 日持つので開ける。
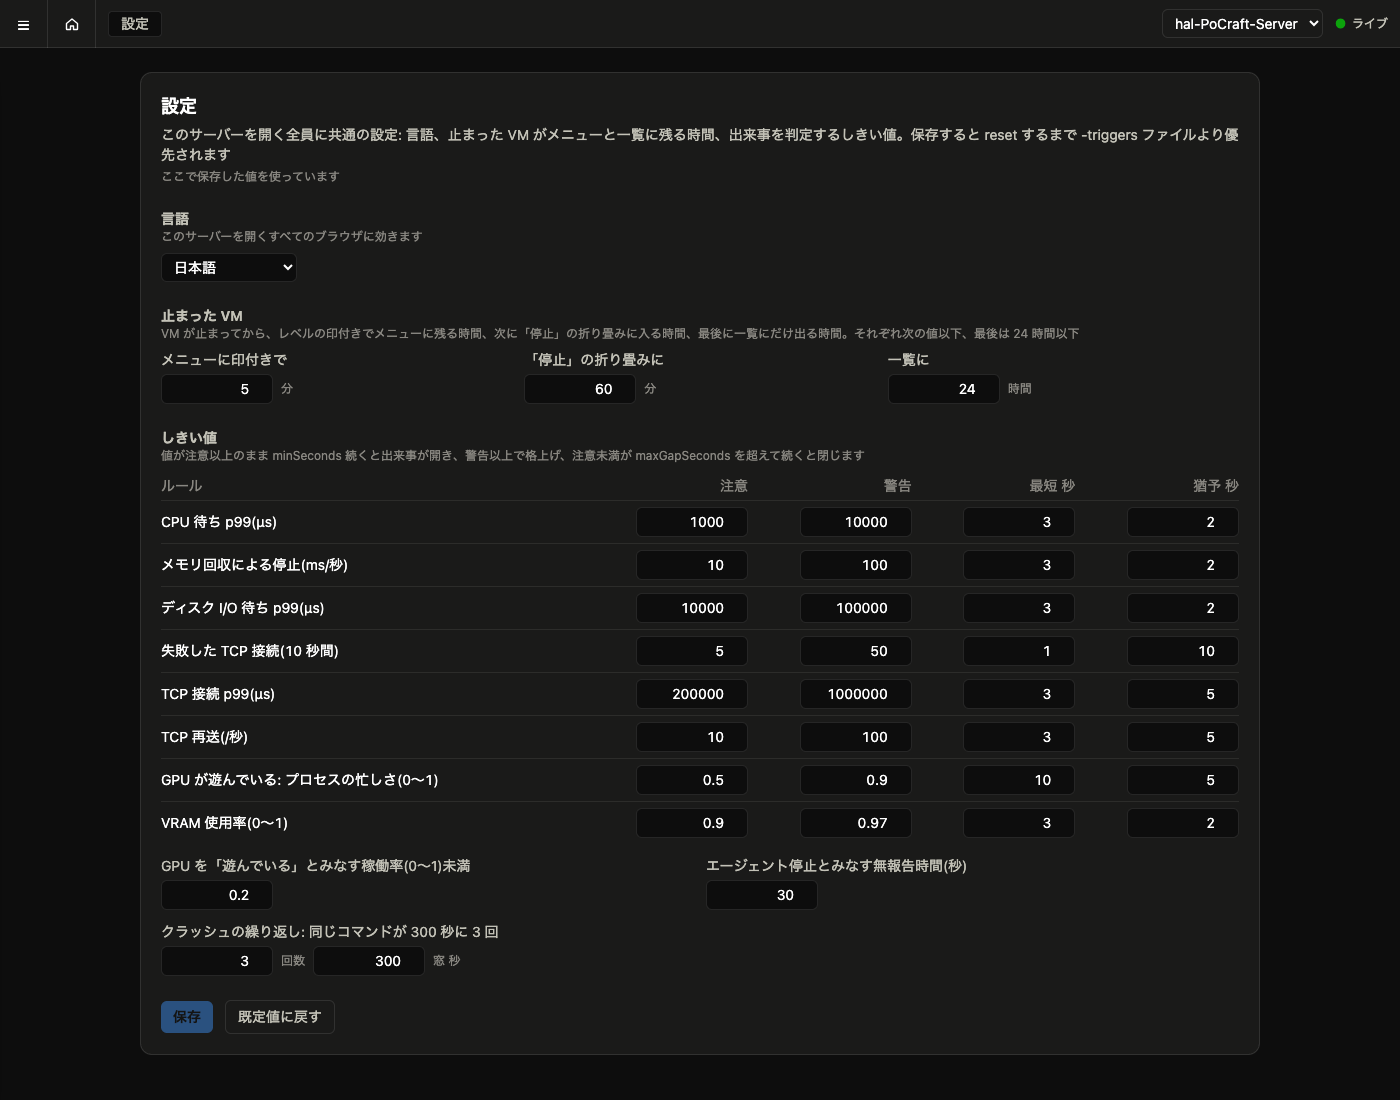
設定画面。 その境目の時間と、全ルールのしきい値を画面から変えられるようにした。保存値は SQLite の settings テーブルに入り、評価器はロックの下で設定を差し替える。優先順位は 既定値 ← -triggers ファイル ← 画面。言語の切り替えもヘッダーからここへ移した。言語は 1 つのブラウザではなく、このサーバーを開く全員の属性だからだ。
まとめ
一日でロードマップの 1〜11 が埋まった。振り返ると、引っかかったのはどれも「その文脈で current は誰か」「その呼び出しはどこで止まるか」「カーネルはそれを知っているか」の 3 つに帰着する。
- 転送は synchronize でなく memcpy の中で止まる
- リクエストの issue はワーカーの文脈で走ることがあり、bio は split と merge で持ち主を失う
- GPU の稼働率はカーネルの外にあり、GeForce はプロセス別にはくれない
- 1 秒の接続遅延は距離ではなく再送
eBPF は「取れるものは何でも取れる」道具に見えるが、実際には取れる場所と取れない場所の境界を一つずつ確かめる作業だった。その境界を README と ADR に書き残すことが、この道具を「誰でも SRE と名乗れる」ものにするための、たぶん一番地味で一番大事な部分だと思う。
エージェントは相変わらず CAP_BPF と CAP_PERFMON だけ、uprobe 込みで 1 コアの 2%、46 MB。コードは github.com/y6ui3i/ebpf-lens(Apache-2.0)。
コメント