前回の最後に「キーワード検索を自前で足せば、月 350 ドルの固定費なしでハイブリッド検索が手に入るはず」と書いた。paperlake(紙資料 → OCR → Markdown → Bedrock Knowledge Base → MCP)は v1.0 で区切り、検索基盤の自作は別プロジェクト lakebed として始めた。1 日で組んで同じ 40 問で測った結果、日本語特化の埋め込みモデル + BM25 + 再ランクの組み合わせが、AWS 側の最良構成を精度で上回った。費用ゼロ、1 問 0.4 秒、資料も質問も外に出ない。この記事はその組み立てと、途中で踏んだ 4 つの穴の話である。
paperlake と lakebed の境界
paperlake 側は一切変えず、出力ファイルの形だけを契約にした。paperlake が S3 に置く Markdown(各ページの先頭に [p.N | 印刷 M] のマーカー、章題は ## 見出し)と、資料名・著者・登録日を持つメタデータの JSON。lakebed はこれを読んで索引を作る。
構成はこうなる。
Markdown + メタデータ
  └─ チャンク分割 (章題と [p.N] マーカーを使う)
       └─ 埋め込み (ローカルの GPU。e5 / bge-m3 / ruri-v3 を差し替えて比べる)
            └─ OpenSearch コンテナ (knn_vector + kuromoji の BM25)
                 └─ 検索 API (意味 / キーワード / ハイブリッド、再ランク) ── MCP ── Claude
検索 API の戻り値は paperlake の検索画面が使っている形と同じにした。おかげで paperlake 側は「同じ形の API を持つサーバーを候補に足す」という小さな変更だけで、検索画面の比較表に lakebed の列が並ぶ。
OpenSearch は公式の Docker イメージに日本語の形態素解析(kuromoji)が入っていないので、プラグインを 1 行足した Dockerfile にした。ヒープ 1 GB のシングルノードで、資料 23 冊・1 万チャンク程度なら十分に軽い。
埋め込みモデルを 3 つ比べる
paperlake の Golden セット(40 問、判定は「資料名一致 + 期待ページ ±1 の本文とチャンクの内容が重なる」)で、埋め込みモデルとチャンク長と検索方式を変えて測った。参考として AWS 側の値も並べる。
| 埋め込み | 方式 | hit@1 | hit@3 | hit@5 | MRR | 所要時間 |
|---|---|---|---|---|---|---|
| (AWS) Titan v2 + S3 Vectors | 意味 | 0.400 | 0.750 | 0.825 | 0.570 | 299 ms |
| (AWS) Titan v2 + OpenSearch Serverless | ハイブリッド | 0.550 | 0.850 | 0.875 | 0.690 | 321 ms |
| multilingual-e5-large | 意味 | 0.450 | 0.575 | 0.725 | 0.542 | 56 ms |
| bge-m3 | 意味 | 0.475 | 0.600 | 0.650 | 0.539 | 41 ms |
| ruri-v3-310m | 意味 | 0.375 | 0.650 | 0.800 | 0.543 | 42 ms |
| ruri-v3-310m | ハイブリッド | 0.575 | 0.800 | 0.875 | 0.688 | 97 ms |
| ruri-v3-310m | ハイブリッド + 再ランク | 0.675 | 0.875 | 0.925 | 0.771 | 401 ms |
hit@k は「上位 k 件に正解が入っていた質問の割合」、MRR は正解の順位の逆数の平均(1 位なら 1、圏外なら 0)である。
穴 1: 長いチャンクが先頭しか埋め込まれていない
最初に e5-large で 700 字、350 字、2,000 字のチャンクを比べたら、2,000 字だけ明確に落ちた(hit@3 0.550)。原因はモデルの入力上限だった。e5 は 512 トークンまでで、日本語 2,000 字は 1,000 トークンを超える。8 割のチャンクが途中で切り捨てられ、先頭しか埋め込まれていなかった。700 字なら中央値 350 トークンで収まる。
Bedrock の Titan は 8,000 トークンまで受けるので、Knowledge Base の階層チャンク(1,500 トークン)でも問題にならない。ローカルモデルに替えるときは、チャンク長をモデルの上限に合わせて決め直す必要がある。取り込み時に切り捨てられたチャンクを数えて警告するようにした。
多言語より日本語特化
e5-large(5.6 億パラメータ)と bge-m3(5.7 億)は多言語モデルで、どちらも意味検索の hit@3 が 0.6 前後、Titan の 0.75 に届かない。日本語だけで学習した ruri-v3-310m は、半分の大きさで hit@5 0.800 と Titan に迫り、ハイブリッドにすると AWS の OpenSearch Serverless の構成と同じ値になった。100 言語を 1 つの空間に押し込む多言語モデルより、1 言語に全部の容量を使うモデルが有利、という素直な結果である。
キーワード検索が最強に見えた
方式ごとの比較で、意外なことにキーワード検索(BM25)だけが hit@1 0.650 で一番強かった。意味検索の 0.45 を大きく引き離している。
ただ、これは疑ってかかるべき数字だった。Golden セットの質問は、資料のページ本文を Bedrock の Claude に見せて生成したものだ。本文の語彙がそのまま質問に入りやすく、キーワード一致に有利な物差しになっている。
そこで同じ正解ページに対して、「本文の固有の語を使わず、うろ覚えの話し言葉で聞き直す」言い換え版の 40 問を作った(Sonnet で 0.1 ドル)。「ファイル記述子とは何ですか」が「ファイルを開いたときにシステムから受け取る、そのファイルを操作するための番号みたいなもの」になる、という具合である。
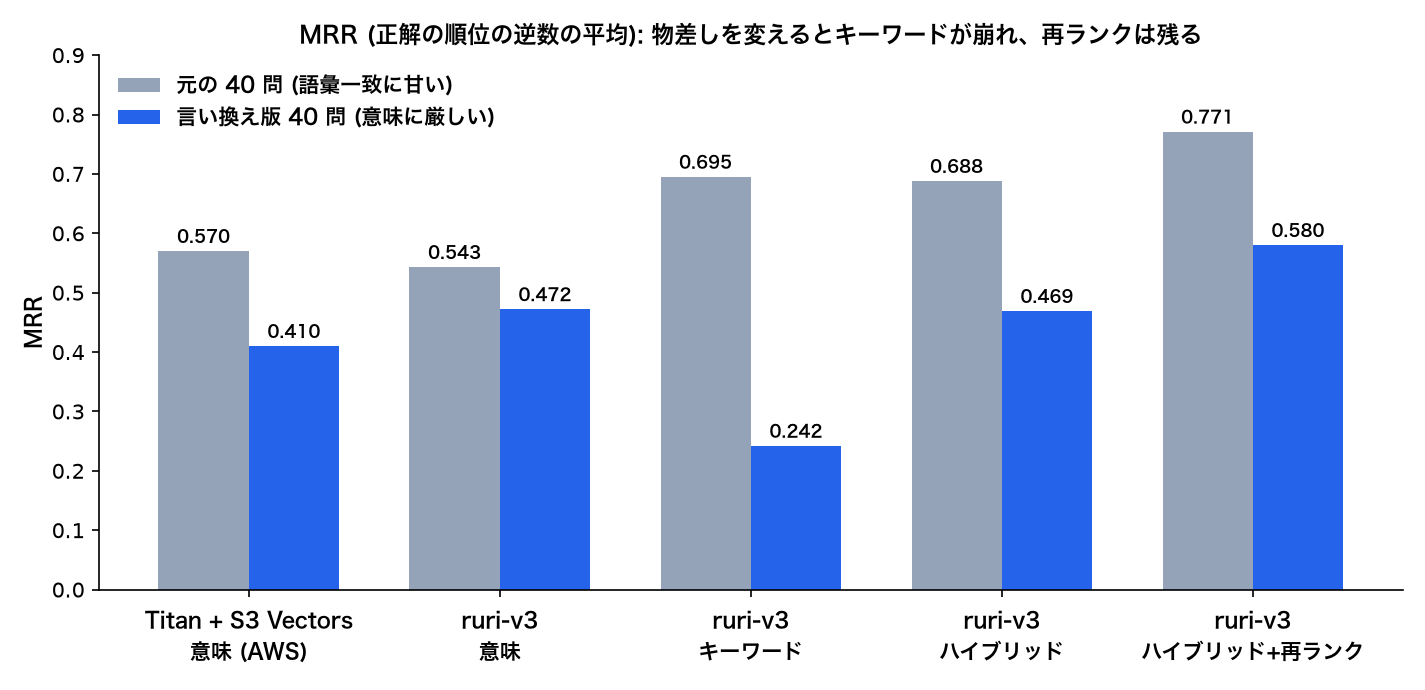
| 埋め込み | 方式 | 元の 40 問 hit@5 | 言い換え版 hit@1 | hit@3 | hit@5 | MRR |
|---|---|---|---|---|---|---|
| (AWS) Titan v2 + S3 Vectors | 意味 | 0.825 | 0.300 | 0.525 | 0.600 | 0.410 |
| ruri-v3-310m | 意味 | 0.800 | 0.350 | 0.600 | 0.650 | 0.472 |
| ruri-v3-310m | キーワード | 0.775 | 0.200 | 0.225 | 0.350 | 0.242 |
| ruri-v3-310m | ハイブリッド | 0.875 | 0.325 | 0.575 | 0.700 | 0.469 |
| ruri-v3-310m | ハイブリッド + 再ランク | 0.925 | 0.475 | 0.675 | 0.750 | 0.580 |
言い換えると順位がきれいに入れ替わる。キーワード検索は hit@1 0.65 から 0.20 に崩れ、意味検索が主役になる。そして意味検索同士では ruri が Titan を上回った(hit@3 0.600 vs 0.525)。元の 40 問では Titan の方が上だったので、Titan の強さの一部は語彙一致に依っていたことになる。
物差しは 1 つでは足りない。元の 40 問はキーワードに甘く、言い換え版は意味に厳しい。片方だけ見ると「キーワードが最強」「意味検索が最強」のどちらにも偏る。以後は両方で測る。
再ランクが一番効く
再ランクは、検索で取った上位 20 件を「質問とチャンクの組」でクロスエンコーダに読ませ、採点し直して並べ替える処理だ。意味検索もキーワード検索も質問と文書を別々にベクトル化して距離を見るので速いが粗い。組で読むと精度は上がるが件数分の推論が要るので、上位だけに使う。
効き目は埋め込みモデルの差を上回った。どのモデルでも hit@5 が 0.9 を超え、MRR は 0.77 前後に揃う。上位 20 件のどこかに正解が入っていれば並べ直しで拾えるので、埋め込みの粗さがそこで吸収される。言い換え版でも MRR が 0.469 から 0.580 に上がった。
穴 2: fp16 にしたら落ちる
再ランクのモデル(5.7 億パラメータ)は fp32 のままだと 1 問 1.1 秒かかった。半精度にしようとして、読み込み時に torch_dtype=float16 を渡したら mat1 and mat2 must have the same dtype, but got Half and Float で落ちる。エンコーダ本体は半精度になるが、末尾の分類ヘッドだけ float のまま残るためだ。読み込んだあとにモデル全体を .half() する形に変えたら通り、入力長も 1,024 から 512 に詰めて(チャンクは 700 字 ≒ 350 トークンなので足りる)、1.1 秒が 0.4 秒になった。精度は 1 問も変わらない。
穴 3: 8 GB の GPU を 3 つで取り合う
新しく 8 冊を登録して lakebed に取り込もうとしたら、CUDA のメモリ不足で落ちた。GPU は 8 GB で、そこに paperlake の OCR エンジン(常駐 3.1 GB)と lakebed の検索 API が同居している。API のプロセスを見ると 3.4 GB も持っていた。
内訳は、朝の比較で 3 つの埋め込みモデルをキャッシュしていたことと、再ランクを fp32 で読んでから半精度に変えた分の残骸だった。PyTorch は解放したメモリをプロセス内に確保したまま持つので、半精度化しても fp32 の分が返っていない。torch.cuda.empty_cache() を 1 行足し、API を再起動したら 1.9 GB になり、取り込みは通った。
GPU が効いている場所は「取り込み時の埋め込み」「検索時の質問文の埋め込み」「再ランク」の 3 つで、どれも小さなモデルだから 8 GB で全部同居できる。ただし同居させるなら、誰がどれだけ持っているかを見ておかないと、こういう事故になる。
穴 4: OpenSearch Serverless に索引を作るときの 403
これは前回の話だが、同じ系統なので並べておく。OpenSearch Serverless は署名に x-amz-content-sha256 ヘッダが無いと 403 を返す。エラーが「Forbidden」なので権限を疑うが、署名の形式の問題だった。ローカルの OpenSearch コンテナにはそもそも認証が無いので、この穴は無い。
MCP は ssh 越しの薄いサーバー
Claude Code から使うための MCP サーバーは、検索 API を HTTP で呼ぶだけの薄いものにした。埋め込みと再ランクのモデルは API 側に常駐しているので、MCP サーバー自体は軽い。
置き場所はサーバー側で、Claude Code の設定は "command": "ssh", "args": ["<サーバー>", "cd ~/lakebed && uv run python -m lakebed.mcp_server"] である。MCP は stdio でやりとりするので、ssh でそのまま通る。手元の Mac にモデルも Python 環境も要らない。初回の応答は ssh 接続と MCP 起動込みで 1.8 秒、以後の検索は 0.4 秒で返る。
Bedrock 経由の paperlake の MCP は、Mac から東京リージョンへ行って埋め込みを計算して S3 Vectors を引いて戻ってくるので 300 ms 台だった。lakebed は同じサーバーの中で完結するので、再ランクを足しても同じ帯に収まる。
精度を決めているのはどこか
索引と近傍探索(HNSW、BM25)の仕組みは AWS でもローカルでも同じで、前回の測定でも S3 Vectors と OpenSearch は 40 問中 1 問しか違わなかった。差が出る部品は 3 つある。
| 部品 | AWS | lakebed | 効き |
|---|---|---|---|
| 索引と近傍探索 | S3 Vectors / OpenSearch | OpenSearch | 同じ |
| 埋め込みモデル | Titan v2 | ruri-v3 | 言い換え版で ruri が上 |
| チャンク分割 | 階層 1,500 / 300 トークン | 700 字、章題で切る | 中くらい |
| 混ぜ方と再ランク | 独自ハイブリッド、再ランク未使用 | RRF + クロスエンコーダ | 最大 |
AWS 側でも Bedrock の再ランクモデルを Knowledge Base に足せば同じくらい上がるはずで、そこは 1 回ごとの課金との相談になる。lakebed は GPU があるので再ランクが無料で回る、というのが構成上の差だ。
まとめ
- paperlake の出力(Markdown + メタデータ)だけを契約にして、検索基盤を別プロジェクトとして 1 日で組んだ。paperlake 側の変更は「同じ形の API を候補に足す」だけ
- 日本語特化の ruri-v3(3.1 億パラメータ、VRAM 1 GB 弱)は、多言語の e5 や bge-m3 より小さくて強い。ハイブリッドで AWS の OpenSearch Serverless 構成と同等、再ランクを足すと上回る(MRR 0.77 vs 0.69)
- キーワード検索が最強に見えたのは物差しの偏り。言い換え版の 40 問で崩れた。物差しは 2 つ持つ
- 再ランクは埋め込みモデルの差を吸収する。fp16 の dtype 不一致は読み込み後に
.half()で回避、1.1 秒 → 0.4 秒 - 8 GB の GPU は OCR・埋め込み・再ランクで同居できるが、誰がどれだけ持っているかは見ておく
- 費用ゼロ、0.4 秒、資料も質問も外に出ない。閉域構成の記事で描いた「検索まで手元で閉じる」形が実物になった
次は、paperlake の完了を検知して自動で取り込む仕組みと、日本語特化の再ランカを同じ物差しで測ることである。
コメント