paperlake は紙の資料を OCR して AWS の Knowledge Base に索引を作るところまでを自前で持っているが、答えを作る側は Claude Code に任せている。その橋渡しをしているのが MCP サーバーで、中身は Python 40 行ほどだ。今回はこの部分を、何が起きているかの順に書く。前回までの記事(OCR、YomiToku の内部)の続きになる。
MCP は「Claude に道具を渡す」約束事
MCP(Model Context Protocol)は、Claude Code や Claude Desktop に外部の道具(ツール)を渡すための取り決めだ。道具は「名前・引数・説明」を持つ関数で、Claude は会話の途中で必要だと判断したら自分でそれを呼び、返ってきた結果を読んで答えを続ける。利用者は「この資料のどこに書いてある?」と聞くだけで、どの道具をどう呼ぶかは Claude が決める。
paperlake の MCP サーバーが持つ道具は 2 つだけである。
| 道具 | 引数 | 返すもの |
|---|---|---|
search_documents |
質問文、件数(既定 5)、資料名(任意) | 該当箇所の本文と、資料名・著者・ページ位置・スコアの一覧 |
list_documents |
なし | 取り込み済みの資料一覧(資料名・著者・ページ数・登録日時) |
「答えを生成する」道具はない。検索して該当箇所を返すところまでがサーバーの仕事で、それを読んで答えを組み立てるのは Claude Code 自身だ。前回、Bedrock の Claude に同じことをさせて図まで描けたのは、この分担のおかげで検索側が生成側を選ばないからでもある。
呼ばれてから返すまで
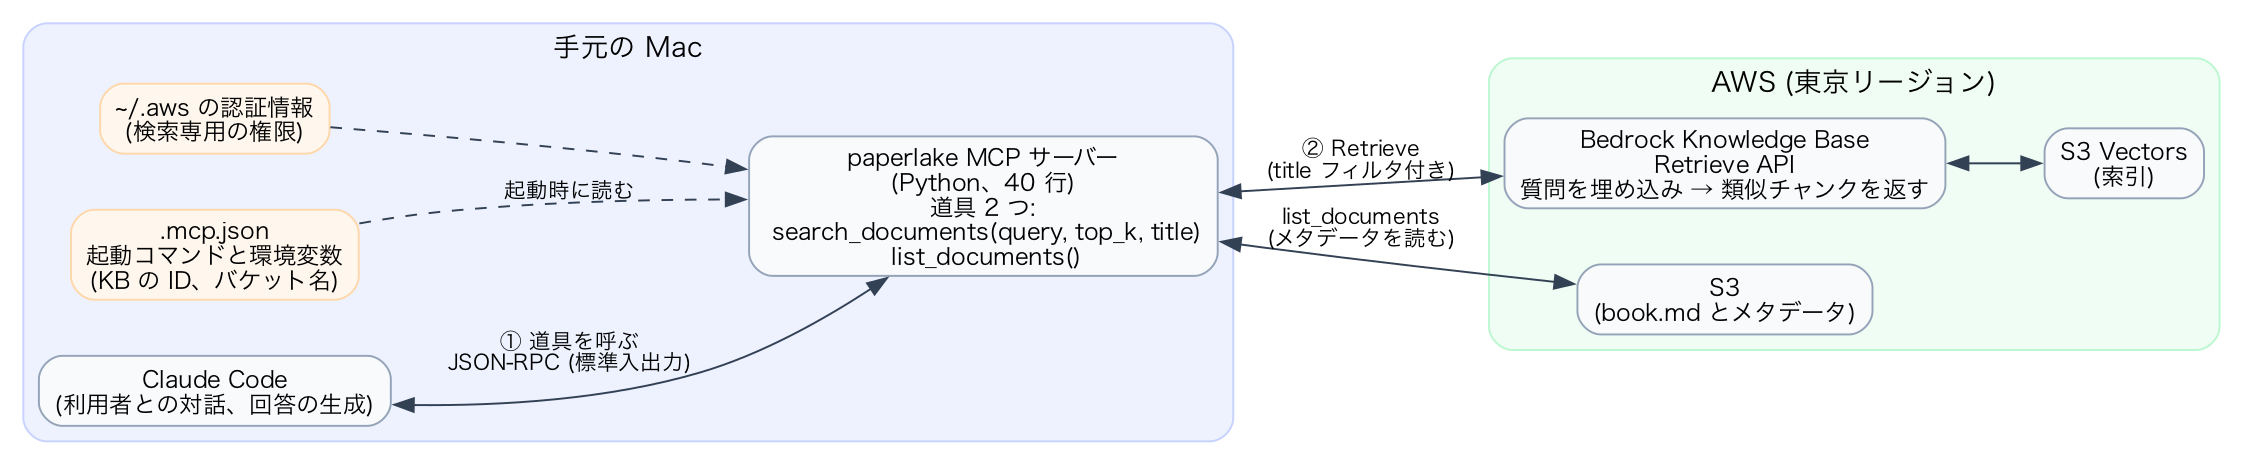
① Claude Code が道具を呼ぶ。 Claude Code は起動時に設定ファイル(.mcp.json)を読み、そこに書かれたコマンドで MCP サーバーを子プロセスとして立ち上げる。以後のやり取りは、その子プロセスの標準入出力を通る JSON-RPC だ。ネットワークもポートも使わない。サーバーが Claude Code に「こういう道具がある」と名乗り、Claude Code は必要なときに「この道具をこの引数で」と書き込む。
② サーバーが Knowledge Base を引く。 search_documents は、受け取った質問文をそのまま Bedrock の Retrieve API に渡す。Knowledge Base 側で質問が埋め込みベクトルになり、S3 Vectors の索引から似たチャンクが返る。資料名が指定されていればフィルタ条件として渡し、索引側で絞る(検索した後で捨てるのではない)。サーバーはこの結果を整形するだけで、埋め込みも類似検索も自分ではやらない。だから 40 行で済む。
③ ページ位置を付けて返す。 返ってきたチャンクの本文には、OCR パイプラインが埋めた [p.12 | 印刷 10] というマーカーが含まれている。サーバーはこれを正規表現で拾い、「入力順の 12 ページ目、印刷ページ番号 10」という位置情報に変換して、本文・資料名・著者・スコアと一緒に JSON 文字列で返す。Claude Code はそれを読んで答えを書き、出典を「資料名の印刷 10 ページ」と示せる。
費用は、質問 1 回につき埋め込み 1 回(Titan Text Embeddings v2 で数百トークン)と Retrieve 1 回で、実質ゼロである。回答の生成は Claude Code 側なので、Bedrock の生成モデルは動かない。
認証と権限
MCP サーバーは手元の Mac で動くので、AWS への認証は手元の ~/.aws の認証情報を使う。設定ファイルに鍵は書かない。この認証情報に必要な権限は Knowledge Base の Retrieve と、資料一覧のための S3 の読み取りだけで、書き込みはできない。索引に資料を入れる側(GPU サーバーのパイプライン)は別の、書き込み専用の鍵を持っている。読む鍵と書く鍵を分けてあるので、どちらかが漏れても被害が片側で止まる。
はまった話: 見た目が同じ題名で 0 件になる
資料名で絞る機能が、正しい題名を渡しても 0 件を返すことがあった。原因は検索側ではなく、登録した題名の文字の正規化形だった。macOS でファイル名をコピーして題名に貼ると、濁点・半濁点が「基底文字 + 結合文字」(NFD)で入ることがある。見た目は同じでもバイト列が違い、索引のフィルタはバイト一致で比べるので、普通に打った題名(NFC)と一致しない。4 冊で起きていた。
対処は、登録時と索引のメタデータ生成時と MCP の引数受け取り時の 3 箇所で NFC に揃えること。どこか 1 箇所だけ直しても、他から入った揺れが残る。同じ調査で、S3 Vectors のフィルタは完全一致しか使えず、前方一致(startsWith)は API がエラーを返すことも分かった。日付で絞りたければ「日付だけの属性」を別に持つ必要がある。
使ってみて分かったこと
- 道具が 2 つしかないのは、少なすぎるように見えて足りている。Claude Code は
search_documentsを言い換えを変えて何度か呼び、結果を突き合わせて答える。件数や絞り込みを増やすより、返す本文にページ位置が付いていることのほうが効いた - 一方で「検索」しかないので、「この資料の 100 ページから 110 ページを読んで」のような連続した読み方はできない。これは次に足すべき道具で、
read_pages(資料名, 開始, 終了)が候補になっている - Bedrock コンソールのテスト画面(RetrieveAndGenerate)より、Claude Code + MCP のほうが使いやすい。コンソールは生成プロンプトが固定で、図を描くような指示が通らない。MCP なら検索結果を受け取った Claude Code が自由に加工できる
まとめ
- MCP は Claude に道具を渡す約束事で、paperlake のサーバーは検索と一覧の 2 つだけを持つ。答えを作るのは Claude Code
- 呼び出しは標準入出力の JSON-RPC、検索は Bedrock の Retrieve API に丸投げ、返すときに OCR 側が埋めたページマーカーを位置情報に変える。だから 40 行で足りる
- 認証は手元の読み取り専用の鍵、費用は 1 問ほぼゼロ
- 題名の正規化形(NFC / NFD)の違いで完全一致フィルタが外れる。登録・索引・検索の 3 箇所で揃える
次は、この検索の当たり方を測るために作った「質問と期待するページ」の評価セットと、それで見えた索引の弱点について書く予定だ。
コメント