手元にある縦書きの紙資料(スキャン画像)を、Claude Codeから「あの箇所どこだっけ」と検索したい。AWSで組みたい。そう思って始めた1日の開発記である。結論から言うと、OCRはクラウドに出さず、家のRTX 2070(8GB)で日本語特化OCRを回すのが正解だった。縦書き432ページが7分で読める。出来上がったものは最初の資料専用ではなくなったので、paperlake という名前で汎用の紙資料パイプラインとして育てることにした。
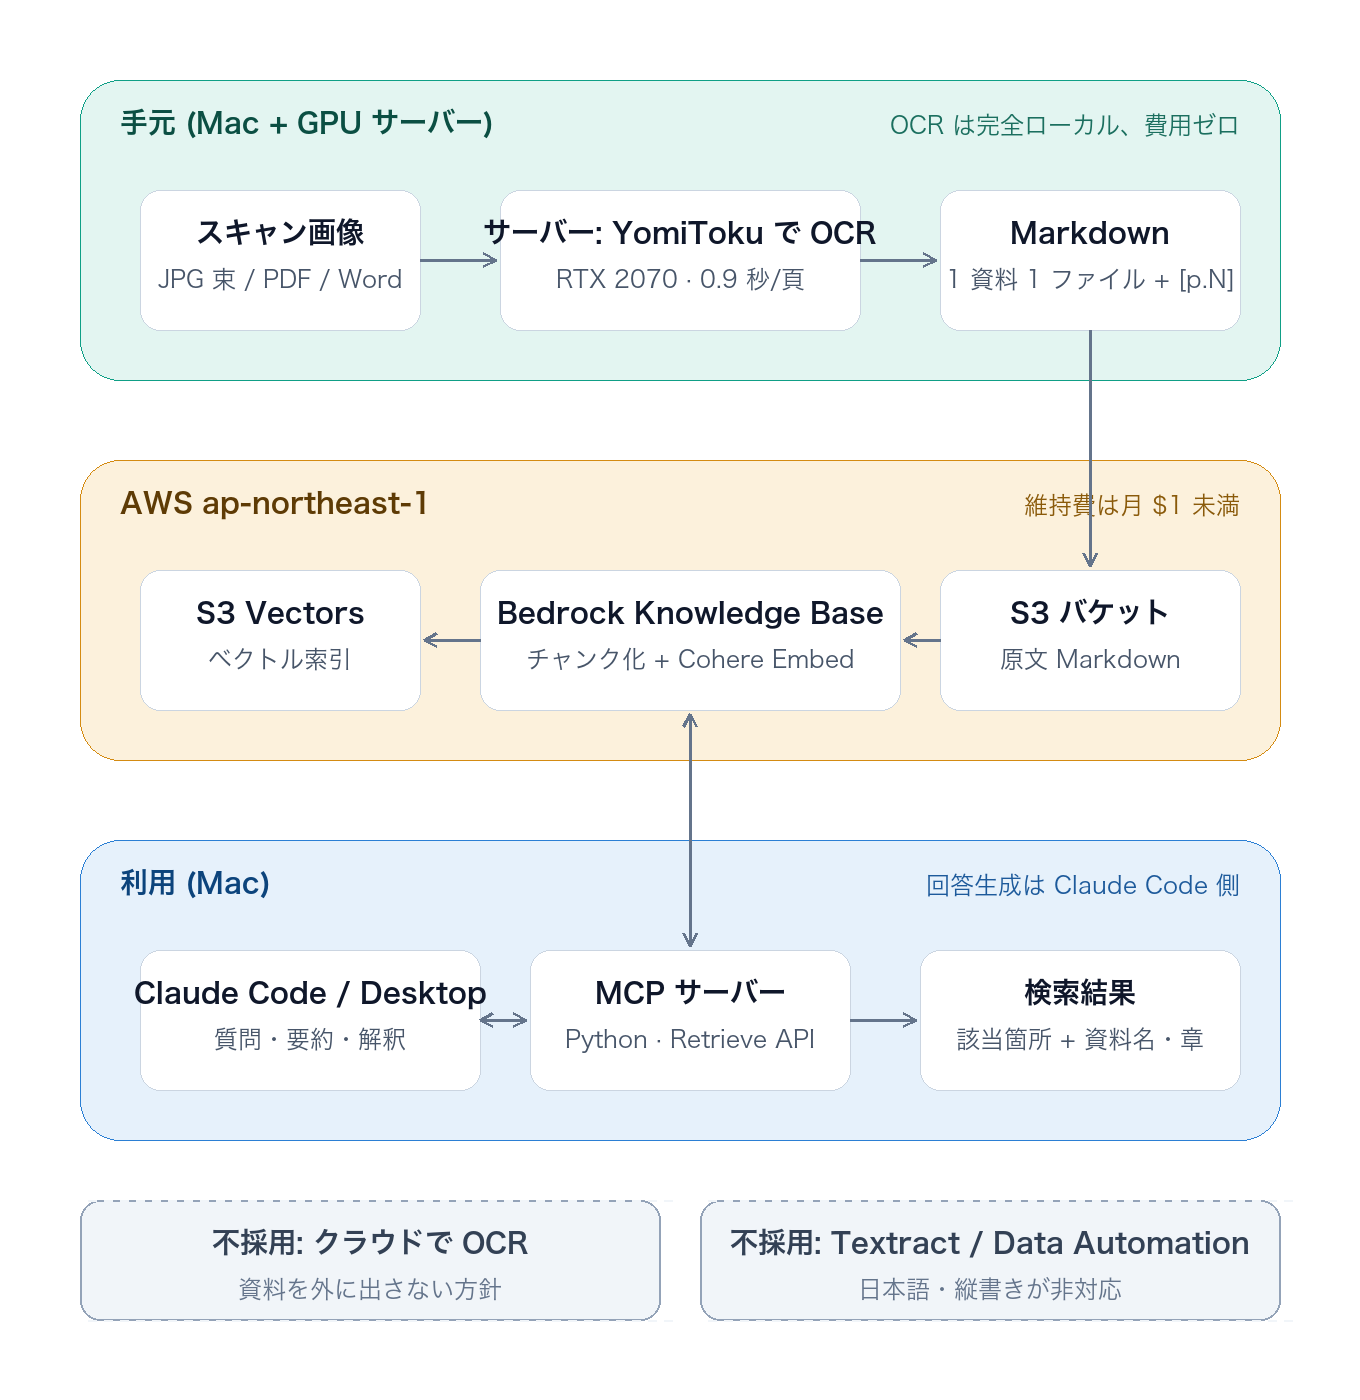
最初に描いた構成図。OCRは手元で済ませ、AWSには索引だけを置く。クラウドでのOCRは検討の末に不採用
先に予算感を出す
素材は画像だけのPDF(OCRなし)と、JPG 432枚をzipにしたものの2件。どちらも日本語の縦書きで、ルビ付き。
AWSで日本語の紙資料をRAGにするとき、まず突き当たるのが AWS純正のOCRが日本語文書に非対応 という事実だ。Amazon Textractの対応言語は英・仏・独・伊・西・葡、Bedrock Data Automationの文書処理も同じ6言語で、縦書きは論外。つまり日本語の画像PDFをBedrock Knowledge Baseに放り込んでも読めない。OCRは自前でやるしかない。
一方、ベクトル側は安い。S3 Vectorsは100万ベクトルで月$0.28、Knowledge Base自体は無料、埋め込み(Cohere Multilingual)は1万ページで$1程度。維持費は月$1未満で、費用の支配要因はOCRだけ、というのが最初の見立てだった。
| 項目 | 費用 |
|---|---|
| クラウドのVLMでOCR(1万ページ、モデルの級による) | 約$30〜180 |
| 埋め込み + S3 Vectors + S3 | 初期$1、月額$1未満 |
| OpenSearch Serverlessにした場合 | 月$175〜350(最低OCU課金) |
この時点では「クラウドのVLMでOCRするか、家のGPUで無料でやるか」の比較のつもりだった。ただ、資料をクラウドに送ること自体を避けたい場面(業務資料)を考えると、OCRは手元で完結させる方が筋がいい。以降はローカルに絞って比べる。
ベンチの設計
2件から各10ページを無作為に抜き(先頭・末尾10%は除く)、同じページ画像を全エンジンに通してCER(文字誤り率)・秒/ページ・VRAM・費用を1つの表にする。エンジンは ocr(image) -> text を持つクラスとしてレジストリに登録し、GPUサーバー(Ubuntu 26.04、RTX 2070 8GB)で走らせる。
正解テキストが無いのがスキャン資料の難しいところだ。最終的には最も精度の高かったエンジンの出力を参照にして「参照との不一致率」を出し、参照エンジン自体は画像と目視で突き合わせて絶対精度を推定するという二段構えにした。
ローカル勢を8GBで動かす
候補は日本語特化の YomiToku、Ollamaで動く Qwen3-VL 4B/8B、0.9Bの文書特化VLM PaddleOCR-VL 1.6。全部つまずいた。
YomiTokuは「Cコンパイラが見つからない」で落ちた。 torch 2.14の torch._native が、eager実行でも注意機構の行列積をtritonカーネルに振る。tritonはランチャの.soをビルドするためにgccを要求し、halにはgccがない(sudoもない)。TORCH_COMPILE_DISABLE=1 では止まらない。torch.compile ではなく eager のオーバーライドだからだ。tritonのオーバーライドを外して aten にフォールバックさせたら通った:
from torch._native import registry as native_registry
native_registry.deregister_op_overrides(disable_dsl_names="triton")
Qwen3-VLは本文が空で返ってきた。 Ollamaの無印タグ qwen3-vl:4b はthinking版で、think: false を渡しても2,224トークン考え込んだ末に num_predict を使い切り、done_reason: length で終わる。qwen3-vl:4b-instruct に替えたら普通に読んだ。
PaddleOCR-VLはモデル読み込みでOOMした。 0.9Bのモデルなのに「7.59GB確保済み」でこける。fp32で重みを読み込む際に一時的に二重に載るためで、FLAGS_allocator_strategy=auto_growth とmanaged memoryでようやく動いたが、VRAM 7.8GBを食う。
結果(参照はYomiToku、CERは「YomiTokuとの不一致率」):
| エンジン | 資料A 10頁 | 資料B 10頁 | 秒/頁 | VRAM |
|---|---|---|---|---|
| YomiToku(参照) | — | — | 0.9 | 2.0〜2.6GB |
| PaddleOCR-VL 1.6 | 0.91% | 0.33% | 20〜28 | 7.8GB |
| Qwen3-VL 4B instruct | 4.5% | 6.4% | 7〜10 | 5.1GB |
| Qwen3-VL 8B instruct | 9.6% | 4.6% | 12〜21 | 7.7GB |
YomiTokuの絶対精度は、2ページを画像と突き合わせて 480〜620字中2〜3字の誤り、CERにして0.5%前後。誤りの型は「〈」が「ヘ」に、「ぼ」が「ほ」に(濁点落ち)、片仮名の「ヘ」と平仮名の「へ」の取り違え。PaddleOCR-VLは精度ではほぼ互角で、誤る箇所が互いに違う。ただし20倍遅い。Qwen3-VLは「っ」が「つ」、「ゃ」が「や」と小書き仮名が潰れ、8Bは行ごと落とすので4Bより悪い。
おまけの発見が一つ。資料BのPDFにはスキャナ付属OCRのテキスト層が入っていた。文字精度はYomiTokuと1%未満で一致するのに、10ページ中3ページで段落の順番を取り違えていた(4段落目から始まる)。YomiTokuは正しい順で読んでいた。テキスト層があるからといって鵜呑みにできない。
パイプラインをWeb UIにする
エンジンが決まったので、halの上でFastAPI + 1枚のHTMLのUIを作った。zip・PDF・画像フォルダを登録するとページ画像に揃え、YomiTokuで読んで、[p.N] マーカー付きの1資料1ファイルのMarkdownにする。ページ画像とOCR結果を並べて目視できるプレビューも付けた。
8GBのGPUでは並列は不可能なので、キュー方式にした。GPUを使うジョブは gpu レーンで1本ずつ、テキスト抽出(電子PDFやWord)は other レーンで別に直列。gpuレーンは flock のファイルロックも取り、ベンチのスクリプトも同じロックを取るので、別プロセス同士でもGPU上で重ならない。キューは meta.json に永続化し、再起動やキャンセルのあとは済んだページを飛ばして続きから進む。
実データでは、資料A(JPG 432枚)が7分22秒、資料B(スキャンPDF 2分割320頁)が6分2秒、どちらも0.97秒/頁。2件続けて登録すると2件目が「queued (gpu 1番目)」で待ち、1件目が終わるとロックを引き継いで始まった。
細かい罠も一つ。Macから rsync -a で送った日本語ファイル名はhal上でNFD(濁点が結合文字)になっていて、UIに入力したNFCのパスが「存在しない」と弾かれた。そのまま→NFC→NFDの順に解決するようにした。
内部設計: コンテナの中で何が起きているか
ここまでの説明だと「Web UIがある」以上のことが見えないので、コンテナ構成とデータの流れを書いておく。
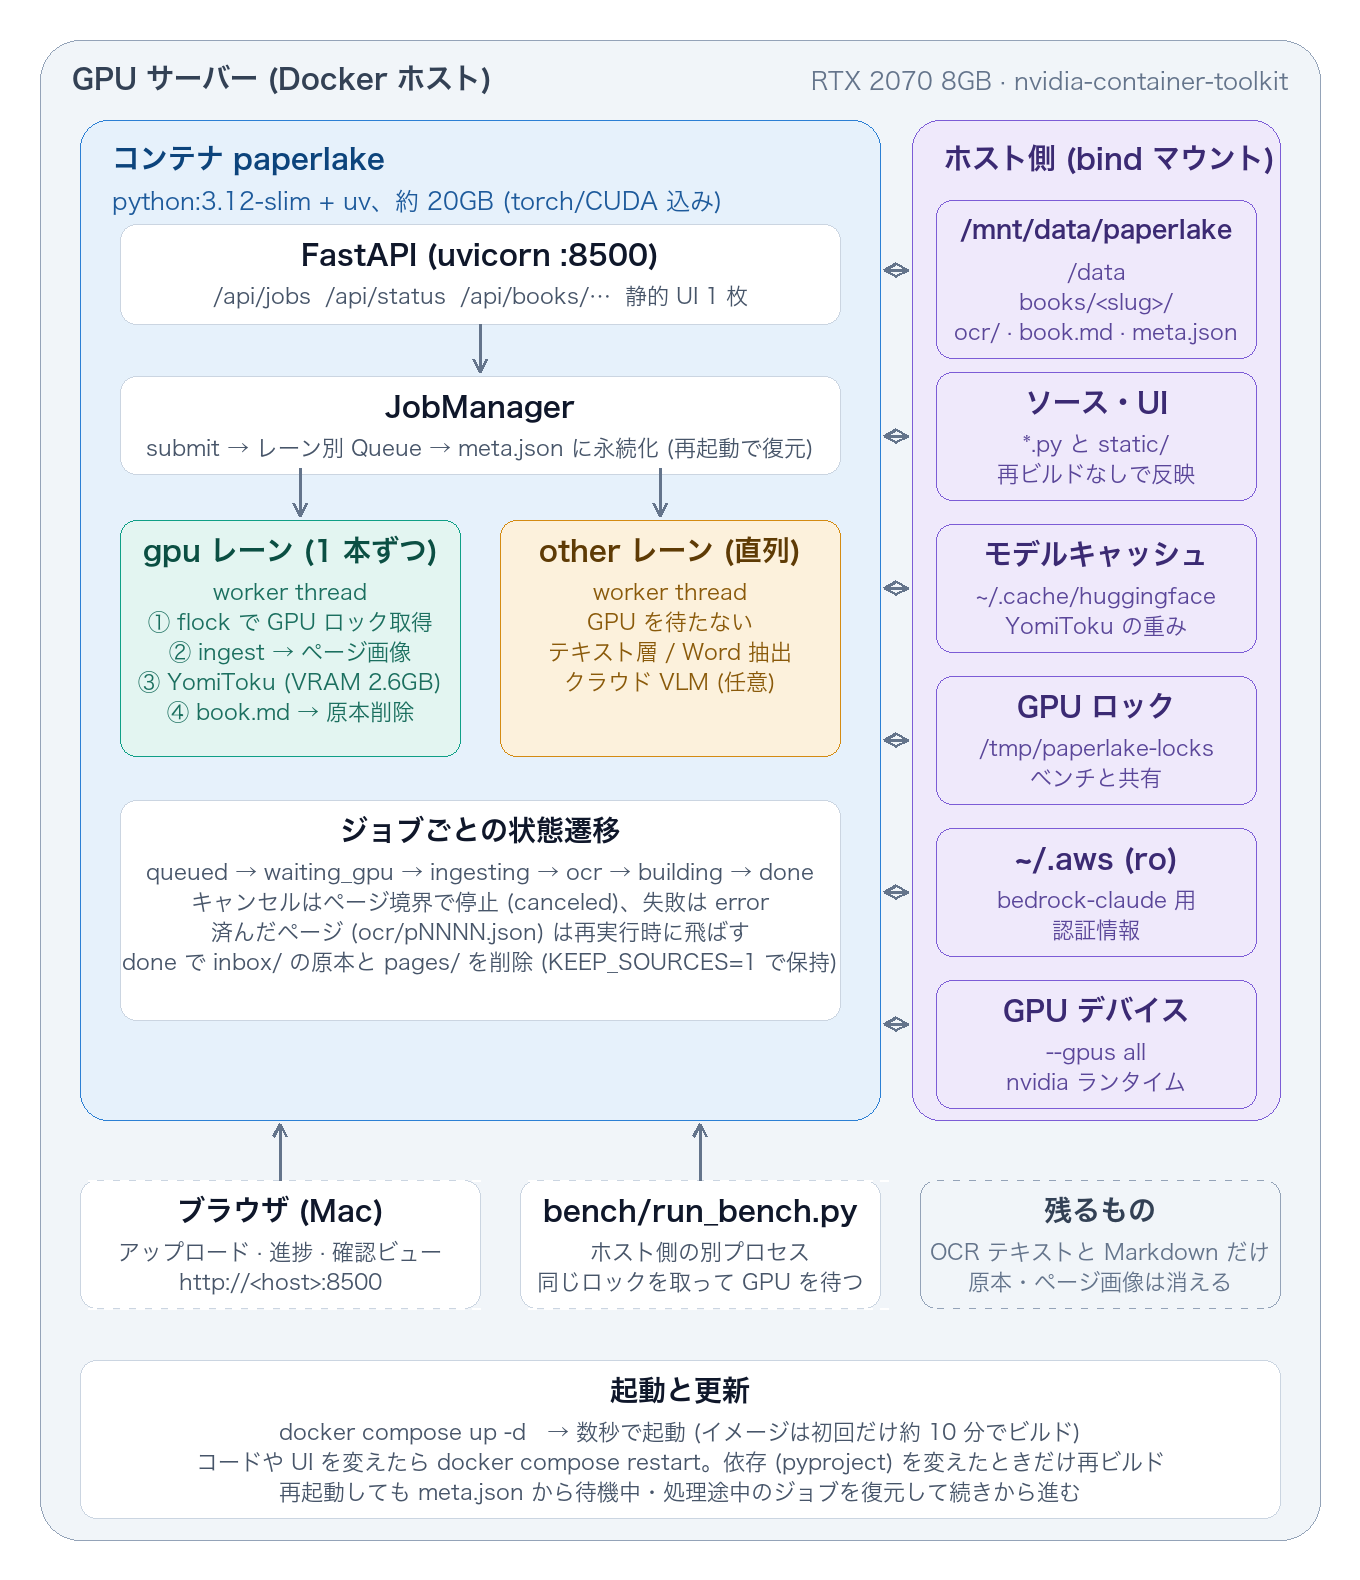
paperlake のコンテナ構成。左がコンテナ内(FastAPI・JobManager・2本のレーン)、右がホストからのbindマウント、下が外から触るもの
図の左がコンテナ、右がホスト側からbindマウントしているもの、下が外から触るものだ。
コンテナは1つ。 python:3.12-slim にuvで依存を入れただけで、torchとCUDAライブラリが載るので約20GBになる。中で動くのはFastAPI(uvicorn)1プロセスと、その中のワーカースレッド2本。GPUは --gpus all(NVIDIA Container Toolkit)で渡す。
ジョブの流れ。 ブラウザからのアップロードは inbox/ に置かれ、JobManagerが入力の種類からエンジンを決めて(スキャンや画像はYomiToku、Wordや電子PDFはテキスト層)、gpu か other のレーンにキューイングする。gpuレーンのワーカーは、①ホストと共有しているファイルロックを flock で取り、②ページ画像に揃え、③YomiTokuで1ページずつ読んで ocr/pNNNN.json に書き、④ book.md を組み立てて、⑤原本とページ画像を消す。otherレーンはGPUを待たずに並走する。
状態はファイルにしか持たない。 ジョブの状態は meta.json、ページごとの結果は ocr/*.json。コンテナを再起動すると meta.json から待機中・処理途中のジョブを復元し、済んだページを飛ばして続きから進む。キャンセルはページ境界で止まる。つまりプロセスが死んでも失うのは「読みかけの1ページ」だけだ。
残るものと消えるもの。 完了時点でサーバーに残るのはOCRテキストとMarkdown(と meta.json)だけで、原本の画像はどこにも残らない。著作物や機密資料をサーバーに置きっぱなしにしないための既定で、自作文書などで残したければ KEEP_SOURCES=1。
ソースはbindマウント。 20GBのイメージを毎回ビルドするのは9分かかるので、*.py と static/ はホスト側のファイルをそのままマウントしている。コードを直したら docker compose restart で反映、再ビルドは依存を変えたときだけ。イメージに焼き込んだ古い app.py で動いていたことに気づいた、という失敗が一度あった。
書き出していて見つけた穴。 GPUロックのファイルをコンテナ内の /tmp に置いていて、ホスト側で走らせるベンチとは排他できていなかった。「別プロセスとも重ならない」と書いた設計が、コンテナ化した瞬間に嘘になっていたわけだ。ロック用ディレクトリをホストと共有するように直し、ホスト側でロックを45秒握ったまま1ページのジョブを投げて、UIが「GPU待ち (host-test)」になり、解放後に動き出すことを確認した。設計を文章にすると、こういうのが出てくる。
git add -A がスキャン画像を拾った
コードの整備中、git add -A が Book/ の117MBのzipを拾い、GitHubの100MB制限でpushが拒否されて発覚した。制限に引っかからないサイズなら公開されていたところで、ゾッとした。リモートには到達していないが、これを機に:
CLAUDE.mdに「著作権物をGitHubに上げない」を絶対ルールとして明文化scripts/check_no_copyrighted.shで追跡ファイルの禁止パス・拡張子、2MB超、全履歴、日本語長文の混入を検査.githooks/pre-pushとCIで自動実行
最初の版は検査スクリプトがソースコードの bench/ocr/ を「OCR結果」と誤検知した。禁止パスは具体的に列挙するに限る。
paperlakeへ
ここまで来ると、もはや最初の資料専用ではない。Word(.docx)と単体画像も受け、電子的に作られたPDFはテキスト層をそのまま使ってOCRを飛ばす(スキャンPDFかどうかは「ページ全面が1枚の画像か」で判別する)ようにして、paperlake と改名した。クラウドのVLMをエンジンとして差せる口は残してあるが、既定はローカルだ。売りは「縦書き・ルビに強い」「資料が外に出ない」「月$1未満」の3つ。
業務に耐えるかと聞かれれば、用途次第だ。CER 0.5%は300ページで約1,000字の誤りなので、検索して該当箇所を見つけて原本にあたる用途には十分だが、条文の引用のように一字一句が問われる用途には人手校正が要る。UIに認証はなく、社内ネットワーク前提。表・帳票・手書きは未検証。
次はS3 + Bedrock Knowledge Base + S3 Vectorsを組み、MCPサーバー経由でClaude Codeから引けるようにする。Claudeの仕事は読むことではなく、探して答えることだ。
リポジトリは近く公開する予定。ベンチの詳細とパイプラインのコードはそちらで。
コメント